主题
开发文档(Day2 1/3)
本页对应 Day02_HTML,共 6 段视频,约 51 分钟。
学习目标
- 能独立写出符合规范的 HTML 文档声明与基本页面结构(
html、head、body),并说明文档声明和基本结构的作用。 - 能使用 W3C、W3CSchool、MDN 等开发文档查找指定 HTML 标签,并判断标签是否已被新标准弃用。
- 能按语义正确使用
h1–h6和p完成文章标题与段落排版,并说明标题标签与title的区别。 - 能正确使用
hr、br实现分隔线与换行,并识别二者为单标签。 - 能使用
pre保留文本中的空格、缩进和换行,并说明其在展示代码场景中的作用与限制。 - 能说明
div无语义、常用于页面布局且可嵌套,并能判断标题、段落等标签不应随意嵌套自身。
知识点
回顾:HTML 文件的基本骨架
为什么需要:浏览器要知道用哪种标准解析页面,页面也要有稳定的结构,后续学标签才有落点。
怎么想:先记三件事——文档声明、基本页面结构、标签与属性。文档声明告诉浏览器用标准模式解析,避免怪异模式;html、head、body 是基本结构。
怎么做:在 VS Code 中新建 .html 文件,先写骨架,再写注释和内容。注释可用 Ctrl + /。
html
<!DOCTYPE html>
<html lang="en">
<head>
  <meta charset="UTF-8">
  <title>标题栏标题</title>
</head>
<body>
  <!-- 页面内容写在这里 -->
</body>
</html>易错点:文档声明不区分大小写,但建议按规范写;head 里的 meta charset="UTF-8" 是为了避免乱码;title 是标题栏标题,不是正文里的 h1。
怎样学一个标签:语义、属性、单双标签
为什么需要:HTML 阶段主要就是学标签,不能靠死记硬背。
怎么想:视频里反复强调三点——先看语义功能,决定“什么时候用”;再看这个标签自己的属性怎么设;最后看它是双标签还是单标签。属性要跟着标签走,有些属性是所有标签都有的全局属性,后面单独讲。
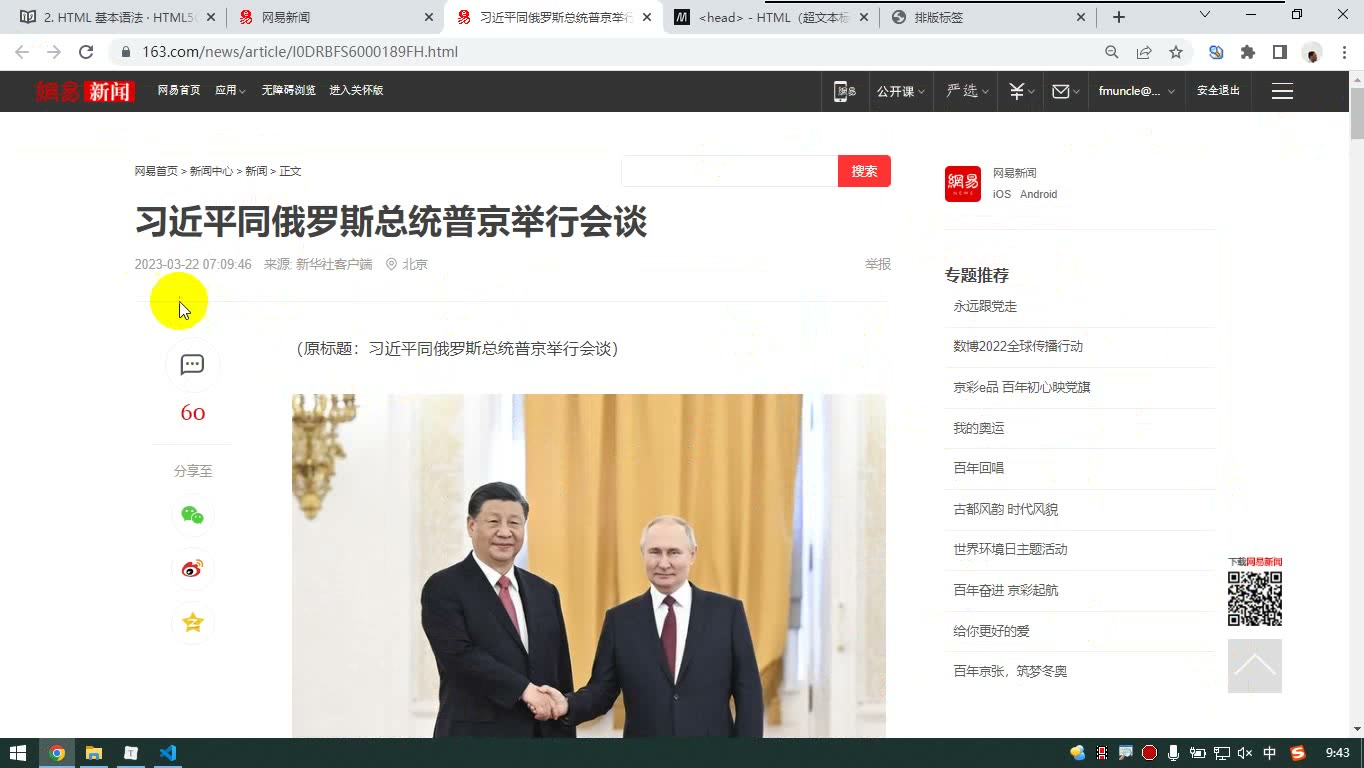
怎么做:判断自己是否掌握一个标签,也按这三点检测。比如看到新闻页的标题,右键“检查”,能看到它用的是 h1,这就是从语义反推标签。
易错点:把“又黑又粗又大”当成使用标题的理由;看到某个标签有属性,就以为别的标签也有。
开发文档怎么用:W3C、W3CSchool、MDN
为什么需要:标签很多,遇到陌生标签或争议时要查权威资料。
怎么想:W3C 是制定标准的组织,文档最官方但偏全、偏英文;W3CSchool 有中文参考;MDN 由开发者共同维护,更贴近实际开发。文档是“参考手册”,不是学习主线。
怎么做:在 MDN 里找“HTML 元素”,按首字母排序查看;带删除符号的表示新标准不推荐使用。浏览器会向下兼容,旧写法可能还能跑,但新项目不要再用。
易错点:照着文档从头学,学习曲线太陡;看到“新标准不支持”就以为浏览器完全不认,其实可能只是不推荐。
标题与段落:h1–h6 和 p
为什么需要:网页最初就是文章,新闻页也大量使用标题和段落。
怎么想:h1 到 h6 是正文标题,h1 权重最高;使用标题是因为“这几个字就是标题”,不是为了样式。样式以后交给 CSS。p 表示段落,段落之间默认有空行,这是标签自带的外边距。
怎么做:
html
<h1>一级标题</h1>
<h2>二级标题</h2>
<h3>三级标题</h3>
<p>这是一个段落。</p>
<p>这是另一个段落。</p>调试时可在新闻页右键“检查”,用 Ctrl + F 搜 h1、h2、h3,能看到页面中标题的使用。
易错点:一个页面通常只建议一个 h1;不要为了加粗放大而用标题;p 里不要再套 p,浏览器会自动修正结构,但不符合规范。
分隔线、换行与原格式:hr、br、pre
为什么需要:文章需要分隔内容、强制换行,代码展示还要保留空格和缩进。
怎么想:浏览器不认源码里的普通换行和多个空格;hr 表示分隔,br 表示换行,pre 表示按原格式显示。
怎么做:
html
<p>锄禾日当午,<br>汗滴禾下土。</p>
<hr>
<pre>
床前明月光
疑是地上霜
</pre>pre 里多个空格和换行会被保留,适合显示代码;但 pre 里的 HTML 标签仍会被解析,要原样显示标签还得学字符实体。
易错点:用一堆 br 堆空行;pre 内容不顶格写,导致前面多出缩进;以为 pre 能原样显示所有 HTML。
div:无语义但最常用的布局容器
为什么需要:页面里很多区域说不清具体语义,但需要包起来做布局。
怎么想:能明确是标题、段落就用语义标签;说不清“这一块是什么”就用 div。div 本身没有效果,配合 CSS 做布局,所以特别常用,也可以嵌套。
怎么做:
html
<div>
  <h1>页面标题</h1>
  <p>页面内容。</p>
</div>易错点:不要死记“谁能套谁”,要想语义:标题里再套标题不合理,段落里再套段落也不合理;div 是结构容器,嵌套 div 很常见。
回顾的定位:先搭骨架,再按三点学标签
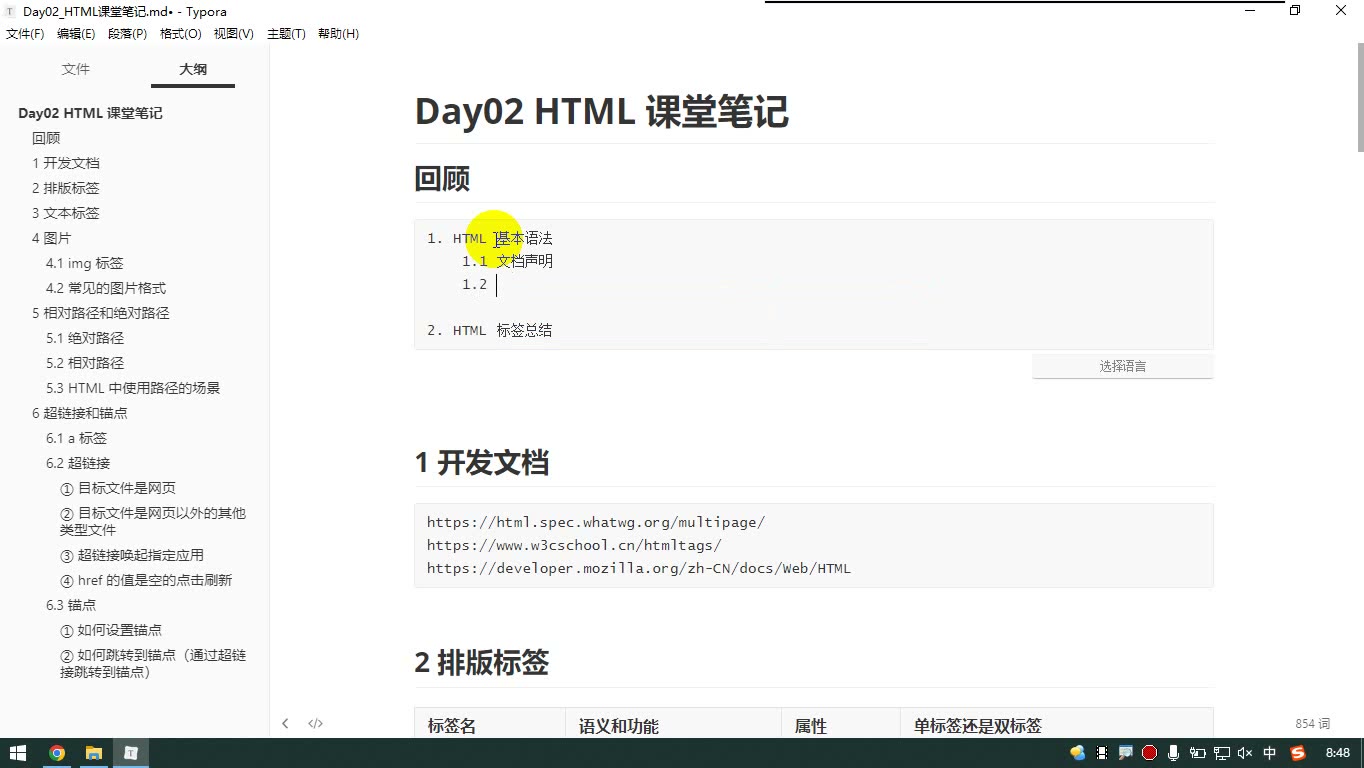
这一节叫“回顾”,不是重新铺开讲新标签,而是把前面学 HTML 的骨架收拢:一块是 HTML 基本语法,一块是标签总结。转写稿里反复强调,标签不用死记硬背,但要用三个问题自检:它的语义功能是什么、它有哪些属性及属性值怎么设置、它是单标签还是双标签。后面每学一个标签,都按这三点走;判断自己会不会,也按这三点检测。
文档声明:先告诉浏览器按标准模式解析
为什么需要:文档声明的作用是告知浏览器使用标准模式解析页面,避免进入怪异模式。转写稿说,现在高级浏览器不写一般也不容易出事,但开发规范已经养成,所以文档声明必不可少。
怎么想:把它理解成“开头的模式说明”,不是页面内容。前几天每次带写,就是为了形成肌肉记忆。
怎么做:在 HTML 文件最前面写文档声明,形式是尖括号加 DOCTYPE html;转写稿也说明它不区分大小写,不必纠结大小写。
易错点:不要把文档声明当成普通双标签;不要因为“不写也能显示”就省略。回顾时先检查它是否写在最前面。
基本页面结构:html、head、body 要写全
为什么需要:基本页面结构是页面的骨架。转写稿明确说,不写这些浏览器也能把网页展示出来,但其实是浏览器自动补上的;基本结构是必须的,所以我们要自己写全。
怎么想:html 是根,里面放 head 和 body;head 放页面元信息,body 放页面内容。结构标签语义简单,都是双标签,而且没什么属性。
怎么做:按“文档声明 → html → head → body”的顺序搭好,再在 head 里写 meta charset 和 title。转写稿提醒,html 包裹的标签要闭合,head 里包裹的也要闭合。
易错点:漏掉结束标签;把页面内容写进 head;以为浏览器能自动补就可以不写。调试时先看结构是否完整、标签是否闭合。
如何掌握一个标签:语义、属性、单双标签
为什么需要:HTML 阶段主要就是一个个学标签,没有自检标准就会变成背属性。转写稿说,标签的语义功能至关重要,它决定“什么时候用这个标签”。
怎么想:先问“它是干什么的”,再问“它有什么属性、属性值怎么设”,最后问“它是单标签还是双标签”。属性要跟着标签走:这个标签有的属性,另一个标签不一定有;有些所有标签都有的叫全局属性,后面会专门讲,现在总结的是标签单独具有的属性。
怎么做:每学一个标签,按三点记;判断有没有掌握,也按三点检测。转写稿说大部分标签并没有一大堆属性,工作量没有想象中艰巨。
易错点:死记属性而不理解语义;把样式效果当成使用理由;把全局属性混进单个标签总结里。
注释:解释说明与临时停用
为什么需要:注释有两个作用:一是对代码解释说明,二是有些代码暂时不想执行可以先注释掉。转写稿说用 VS Code 写时按 Ctrl + / 很方便,但注释的写法也要会。
怎么想:注释是给人看的,不参与页面展示;需要说明或临时停用代码时再用。
怎么做:用 <!-- 注释内容 --> 的写法;在 VS Code 中可用快捷键生成。
易错点:注释写法要会,不要只依赖快捷键;不要把注释当成页面内容。
标签总结:结构标签与 head 中的标签
为什么需要:这一节把已学标签归成两组,方便按“语义—属性—单双标签”复习。转写稿说结构标签就是“一个根、一个头、一个身体”,每个页面都必须有;head 中用了 meta 和 title。
怎么想:html 是根标签/根元素,head 是头,body 是身体;meta 的语义是设置页面元信息,当前重点用 charset 做字符集编码,目的是避免乱码,转写稿说更详细的编码讲解会在后面 JS 相关应用中展开;title 是标题栏标题,为了和后面内容里的 h1 区分,才叫“标题栏标题”。title 没什么属性,是双标签。
怎么做:结构标签直接写全;meta 关注 charset 属性值;title 写在 head 里。本节笔记的总结代码保留如下:
html
1. HTML 基本语法
	1.1 文档声明
	1.2 基本页面结构
	1.3 如何掌握一个标签
	    标签的语义、功能
	    标签的属性以及属性值如何设置
	    标签是单标签和双标签
	1.4 注释
2. HTML 标签总结
   2.1 结构标签
       html
       head
       body
   2.2 head 中的标签
   	   meta	 charset
title易错点:把 title 和内容标题 h1 混为一谈;charset 不写或写错导致乱码风险;结构标签都是双标签、没什么属性,不要额外编属性。复习时按三点过一遍,比死背更稳。
开发文档:先知道去哪儿查
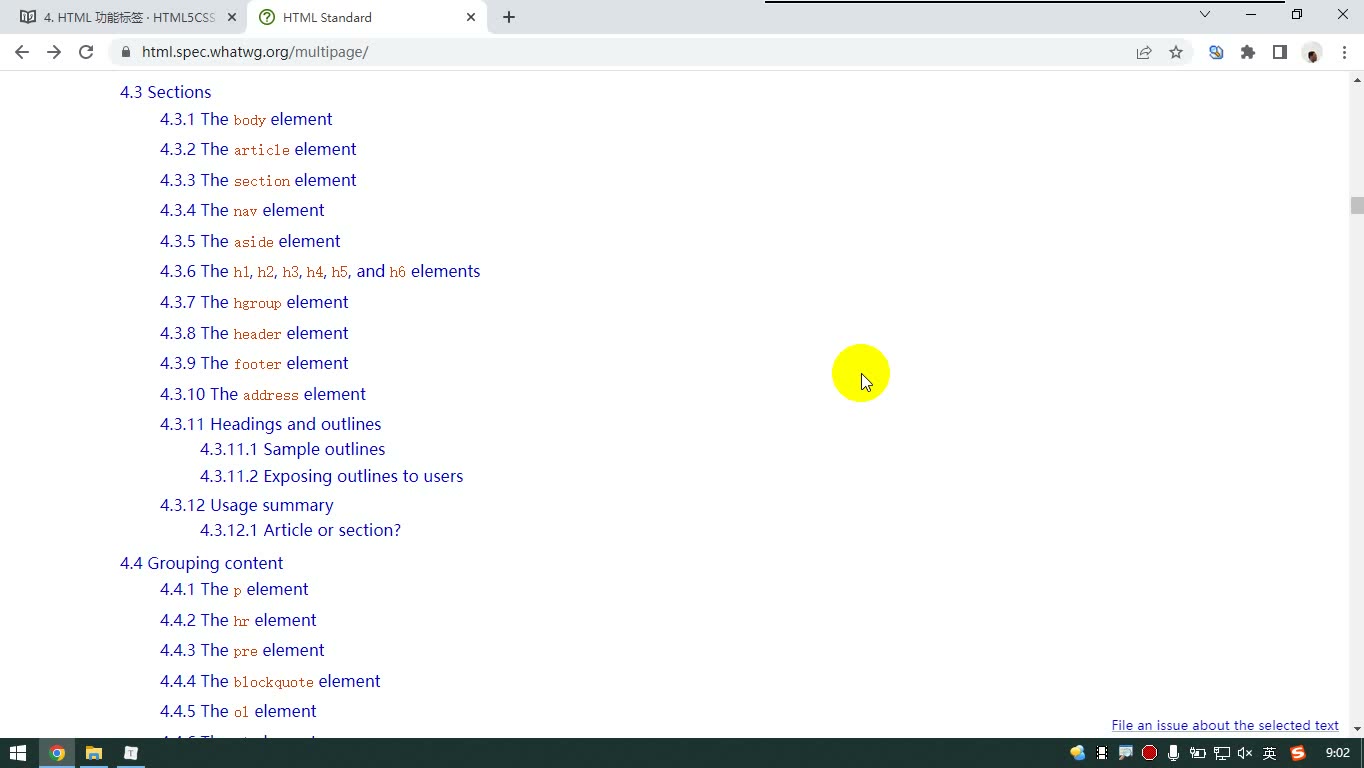
为什么需要:HTML 标签很多,课堂不可能一次讲完;遇到陌生标签、属性或兼容性问题,需要查权威资料。怎么想:W3C 官网最官方但偏规范、全英文;W3CSchool 是中文参考手册;MDN 由开发者共同维护,更贴近实际开发。怎么做:本节笔记保留三个入口:
- W3C 官网:https://html.spec.whatwg.org/multipage/
- W3CSchool:https://www.w3cschool.cn/htmltags/
- MDN:https://developer.mozilla.org/zh-CN/docs/Web/HTML
查标签时按首字母找,例如 head、h1、p。易错点:文档是“参考书”,不是学习主线;W3C 文档会列出全部特性和历史来龙去脉,初学照它学路线太陡。MDN 中带删除符号的标签表示新标准不推荐使用,例如滚动效果相关标签,课堂不总结,实际应交给 CSS/JS 做。搜索 MDN 时注意别点广告,认准 Mozilla 官网。
回顾:HTML 文件的基本骨架
为什么需要:先有稳定骨架,浏览器才知道按什么标准解析。怎么想:文档声明告诉浏览器用标准模式,避免怪异模式;html 包住 head 和 body;head 放页面元信息,body 放页面内容。怎么做:
html
<!DOCTYPE html>
<html>
<head>
  <meta charset="UTF-8">
  <title>排版标签</title>
</head>
<body>
  <!-- 页面内容写在这里 -->
</body>
</html>易错点:DOCTYPE 不区分大小写,但建议写规范;meta charset 用 UTF-8 避免中文乱码;title 是“标题栏标题”,不是页面内容里的 H1。标签掌握三点:语义功能、属性及属性值、单标签还是双标签。属性要跟着标签走,不是每个标签都有同一套属性。
标题与段落:语义优先
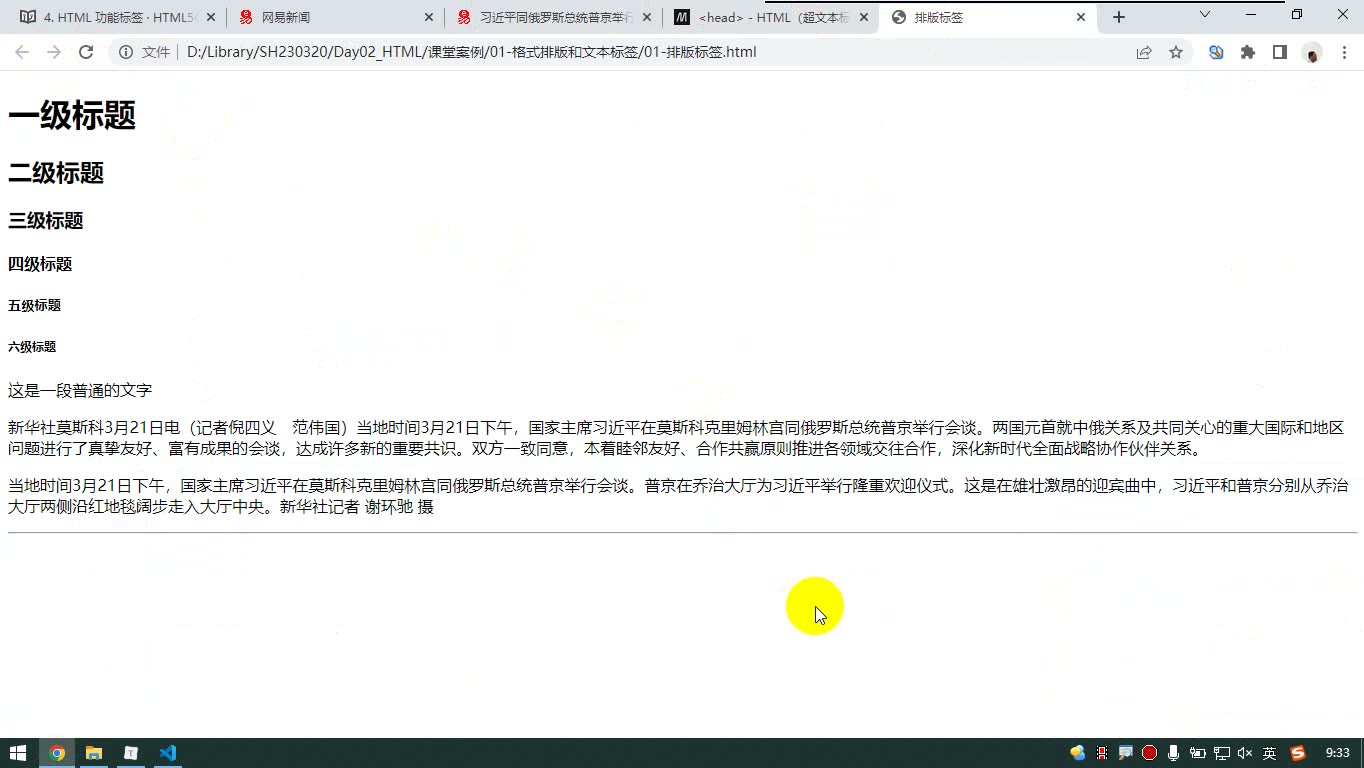
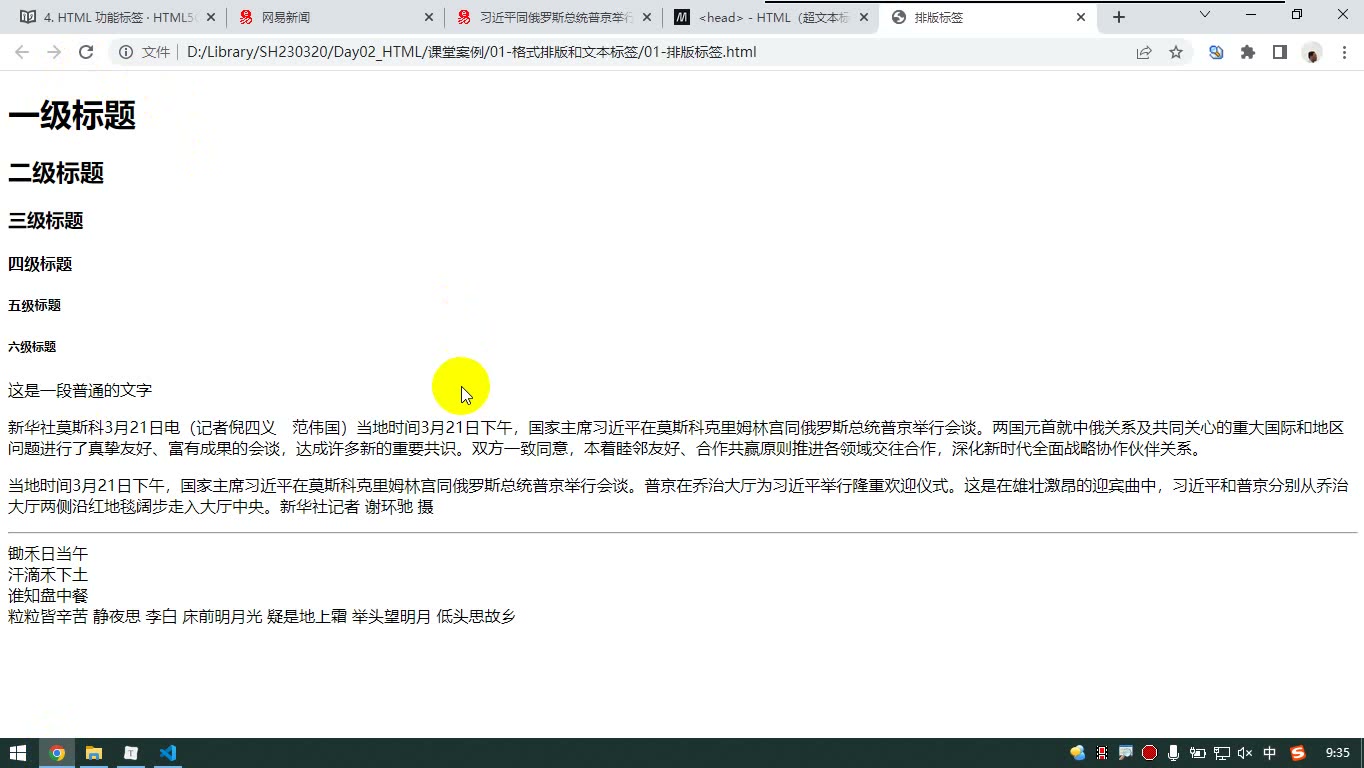
为什么需要:文章需要标题层级和段落结构。怎么想:H1—H6 表示网页内容中的标题,H1 是一级标题;P 表示段落。选 H1 不是因为它“又黑又粗又大”,而是因为这些字在语义上就是标题;默认样式是历史原因,样式以后交给 CSS。怎么做:
html
<h1>一级标题</h1>
<h2>二级标题</h2>
<h3>三级标题</h3>
<h4>四级标题</h4>
<h5>五级标题</h5>
<h6>六级标题</h6>

<p>这是一段普通文字。</p>
<p>这是第二段文字。</p>调试时可在新闻页右键“检查”,用 Ctrl+F 搜 <h1>、<h2>、<h3>,能看到页面中标题的真实使用。易错点:不要为了加粗变大而用标题;一个页面通常建议只用一个 H1,便于搜索引擎和屏幕阅读器判断重点;P 里不要再套 P,浏览器会按规范自动拆解,检查元素时能看到它被拆成两个段落。
分隔线与换行:两个单标签
为什么需要:文章需要分隔内容、诗句需要强制换行。怎么想:HR 语义是分隔,表示上下是两部分独立内容;BR 语义是换行。怎么做:
html
<p>第一部分</p>
<hr>
<p>锄禾日当午,<br>汗滴禾下土。</p>易错点:在普通文本里直接敲回车或多个空格,浏览器通常只当一个空格,不按源码换行显示;要换行用 BR。HR、BR 都是单标签,课堂示例中它们没有需要特别记的属性。
原格式显示:PRE
为什么需要:网页中要展示代码时,代码里的缩进、空格、换行必须保留。怎么想:普通文本会合并空格、忽略源码换行;PRE 表示“原格式显示”。怎么做:
html
<pre>
静夜思
    李白
床前明月光
疑是地上霜
</pre>易错点:PRE 前面的缩进也会被保留,所以标签内容不要随便缩进;PRE 能保留格式,但内部的 HTML 标签仍会被浏览器解析,例如写 <h1> 仍会变成标题。若要在页面中原样显示标签,还需要后续学字符实体。
DIV:无语义布局容器
为什么需要:页面中很多区域说不清具体语义,例如导航区、侧边栏、内容块,需要一个通用容器包起来。怎么想:DIV 无语义,本身没有效果,主要配合 CSS 做页面布局;它能嵌套 DIV,HTML 结构常靠它组织。怎么做:
html
<div>我是 DIV</div>
<div>
  <div>结构中的结构</div>
</div>易错点:不要因为“语义化”就把所有块都硬套成语义标签;能明确是标题、段落就用 H、P,说不清的整块再用 DIV。DIV 可嵌套,但 H1 里套 H1、P 里套 P 不合理;不要死记嵌套规则,按语义判断即可。
课堂画面
代码示例
示例一:基本页面结构 + 标题标签与段落标签
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>排版标签-标题与段落</title>
</head>
<body>
  <h1>习近平同俄罗斯总统普京举行会谈</h1>
  <h2>专题推荐</h2>
  <h3>体育</h3>
  <h4>四级标题</h4>
  <h5>五级标题</h5>
  <h6>六级标题</h6>

  <p>这是一段普通的文字,写在了 p 标签里。</p>
  <p>这是第二个段落,段落与段落之间会空出一行。</p>
</body>
</html>要点解释:
<!DOCTYPE html>是文档声明,告诉浏览器用标准模式解析;不写一般也不出错,但属于开发规范,必须写。<html>包裹页面上所有内容,<head>放页面配置,<body>放给用户看的内容,这三层结构缺一不可。<meta charset="UTF-8">设置字符集编码,目的是避免中文乱码,几乎每个页面都要写。<title>是“标题栏标题”,显示在浏览器标签页上;<h1>是网页内容里的标题,两者语义完全不同,别混。h1~h6共六级,都是双标签。选它是因为“这段文字本身就是标题”(语义),而不是因为它又黑又粗又大——那个样式以后交给 CSS。<p>是段落标签,双标签,里面一般直接写文字;段落之间自带的空行是外边距,后面用 CSS 调。- 易错点:标题里不要再套标题、段落里不要再套段落。比如
<p>高<p>低</p></p>不符合规范,浏览器会自作主张拆成两个p,而且不报错,很难发现。
示例二:分隔线 hr、换行 br、原格式显示 pre
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>分隔线、换行与原格式显示</title>
</head>
<body>
  <h1>静夜思</h1>
  <p>作者:李白</p>
  <hr>

  <!-- 源码里敲的回车和多个空格,浏览器统统不认,只当成一个空格 -->
  <p>锄禾日当午,
     汗滴禾下土。
     谁知盘中餐,
     粒粒皆辛苦。</p>

  <hr>

  <!-- 想换行,必须用 br -->
  <p>锄禾日当午,<br>
     汗滴禾下土。<br>
     谁知盘中餐,<br>
     粒粒皆辛苦。</p>

  <hr>

  <!-- pre 原格式显示:空格、换行、缩进全都保留 -->
  <pre>
function sayHi() {
  console.log("你好");
}</pre>
</body>
</html>要点解释:
<hr>是分隔线,<br>是换行,两个都是单标签,不写结束标签;hr的语义是“把上下文分成两部分独立内容”,不只是画一根线。- 关键易错点:HTML 源码里敲多少个回车、多少个空格,浏览器只渲染成一个空格,所以写诗必须用
br才能真换行。 <pre>是原格式显示,双标签,你源码里怎么写它就怎么显示,主要用途是在页面上展示代码,保留代码的缩进。- 易错点一:
pre里的内容如果你在源码中整体缩进了,这些缩进也会被显示出来,所以要么顶格写,要么把内容对齐好(上面示例就是让代码顶格)。 - 易错点二:
pre里写<h1>你好</h1>会被当成真标签渲染,不会原样显示;想在页面里原样显示标签,还得配合后面要学的字符实体。
示例三:div 做页面布局
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>DIV 页面布局</title>
</head>
<body>
  <div>我是DIV</div>

  <div>
    <h2>专题推荐</h2>
    <p>这一整块内容说不清具体语义,就用 div 包起来。</p>

    <div>
      <p>div 里还可以继续套 div。</p>
    </div>
  </div>

  <hr>

  <!-- 不符合规范:段落里再套段落 -->
  <p>高<p>低</p></p>
</body>
</html>要点解释:
div是无语义标签,本身不带任何效果,写个<div>我是DIV</div>和普通文字看起来一模一样,样式全部交给 CSS 拿捏,所以才有“DIV + CSS 布局”这个说法。- 它是双标签,可以任意嵌套:div 套 div 套 div 都没问题,HTML 的页面结构基本全靠它搭。
- 易错点一:
div的语义就是“一块区域”,凡是说不清该用什么标签的地方才用它;标题、段落这种能明确语义的,就别用 div 硬套。 - 易错点二:
<p>高<p>低</p></p>这种段落套段落不合规范,浏览器不会报错,而是自动补结束标签、拆成两个p,页面上看不出异常,但结构已经乱了。判断能不能嵌套,别死记,想语义:标题里再套标题、段落里再套段落,本来就不合理。
常见错误
1. 骨架靠"记得"而不是靠"肌肉记忆" 现象:新建文件后先写内容,回头补 <!DOCTYPE html>、<html>、<head>,补完发现结构对不上,或者 charset 写在了 body 里。 原因:把骨架当成"知识点"去回忆,而不是当成每次开文件的固定动作。 修法:新建 HTML 文件的第一件事就是把 doctype + html/head/body + charset + title 一次敲完,再动笔写内容;用 VS Code 的 ! 快捷片段生成后逐行确认。
2. 块级标签里再套自己 现象:写了 <p>高< p>低</p></p>,浏览器打开看不出问题,一检查元素发现被拆成了两个段落,还多出标签。 原因:只按"我要分段"的直觉嵌套,没有按语义判断——段落里不该再有段落。 修法:判断标准不是"能不能套",而是"语义上合不合理"。标题、段落内部直接放文字;需要分组、包一块内容,用 div。
3. 为了"又黑又粗又大"而用 h1 现象:一个页面里出现五六个 h1,正文里稍微重要的文字都用标题标签,样式对了但结构乱了。 原因:把标签的默认样式当成了标签的用途。 修法:先问"这几个字是不是这一块内容的标题",是才用 h1–h6;只想要大字加粗,留给 CSS。一个页面 h1 只保留一个。
4. 用回车和空格做排版 现象:代码里换了好几行、敲了一串空格,刷新后全变成一个空格,诗还是挤在一行。 原因:HTML 默认折叠空白字符,源码里的换行、连续空格、缩进都不作数。 修法:换行用 <br>,需要保留原始格式(尤其展示代码)用 <pre>;间距、缩进这类视觉需求交给 CSS。
5. 以为 pre 能原样显示任何内容 现象:在 pre 里写 <h1>你好</h1>,页面上真的出现了又黑又大的标题,而不是这段代码本身。 原因:pre 只保留空白与换行,不阻止标签被解析。 修法:要显示标签本身,必须把 <、> 转成字符实体(后续课程内容);现阶段先记住"pre 不等于代码安全区"。
6. 中文显示异常时先去改内容 现象:中文出现乱码,或编辑器里中文被一堆方框标出来,于是反复重敲文字。 原因:前者是 meta charset 缺失或文件保存编码与声明不一致;后者只是编辑器对非 ASCII 字符的高亮提示。 修法:确认 head 里有 <meta charset="UTF-8"> 且文件以 UTF-8 保存;方框属于编辑器显示设置,调整设置里关掉"突出显示非基本 ASCII 字符"即可,与代码无关。
7. 把 MDN / W3C 当教材从头读 现象:打开文档看两屏就关掉,觉得"全是英文、全是看不懂的特性",产生挫败感。 原因:文档是按"穷举所有特性"组织的参考资料,不按人的学习顺序编排。 修法:跟着课程建立主线,遇到具体某个标签拿不准时再去查;看到文档里暂未学到的特性直接跳过。有争议查 W3C,日常实践查 MDN。
练习
1. 盲写骨架 不看笔记,从空白文件开始写出一个完整的 HTML 页面骨架(声明、三层结构、字符编码、标题栏标题),保存为 .html 用浏览器打开,确认标签页标题正确。写完再对照笔记逐行核对,记录漏写或写错的位置。
2. 新闻页排版 给下面这段内容选标签并写出页面:一个大标题"我国科学家实现新突破"、三段正文、一条分隔线、末尾一行"责任编辑:张三"。 要求:为每个标签写一句注释说明"为什么用它";写完后用检查工具确认 h1 只有一个、段落没有被浏览器拆分。
3. 空白行为实验 分别用三种方式在页面上呈现这首四句诗:① 直接敲回车换行;② 用 <br>;③ 用 <pre> 包裹。截图对比三种结果,用一句话解释差异的来源。然后故意在 pre 里放一个 <h2>,观察并解释结果。
4. 反向预测 下面这段代码,先不看浏览器,写下你预测的 DOM 结构,再打开检查元素验证:
html
<p>第一段<p>第二段</p></p>
<h1>大标题<h2>小标题</h2></h1>对照实际结果,说明浏览器做了什么补救,以及为什么这两处都不该这么写。
5. 拆解真实页面 任选一个新闻网站的一篇报道,用检查工具统计 h1、h2、h3 各出现多少次,以及内容区里 div 和 p 的大致比例。回答两个问题:该页 h1 的数量是否合理?那些用 div 的地方,你能说清它们的语义吗?
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 回顾 | 06:31 |
| 2 | 开发文档 | 10:32 |
| 3 | 排版标签-标题和段落 | 20:46 |
| 4 | 排版标签-分隔线和换行 | 01:55 |
| 5 | 排版标签-原格式显示 | 05:15 |
| 6 | 排版标签-DIV | 06:40 |
小结
- 判断"是否掌握一个标签",只看三件事:语义、它独有的属性、单标签还是双标签;三者说不全就是没掌握。
- 语义决定选谁,样式交给 CSS。所有标签自带的加粗、加大、空行都只是历史遗留的默认样式,不是使用理由。
- 浏览器不报错 ≠ 写对了。它自动补结束标签、自动拆分嵌套,恰恰是结构违规的信号,要用检查工具看真实 DOM,而不是看渲染结果。
- 空白折叠是 HTML 的底层行为:源码里的换行、缩进、连续空格一律不作数;要保留格式必须显式使用
br或pre。 - 块级标签能否嵌套,不靠背清单,靠语义推演——想清楚"这块内容里该不该出现这种东西",答案自然浮现。
div无语义却最常用,因为页面里大量区域本来就说不清语义;反过来,凡是能说清语义的地方(标题、段落)就不该用div糊过去。- 文档是查的不是读的:学习曲线靠课程主线,标准争议查 W3C,日常实践查 MDN;带删除线的标签(marquee、font 等)浏览器虽仍兼容,但不应再写进新代码。
- 语义化真正的受众不是用户,而是搜索引擎爬虫与屏幕阅读器——它们靠标签判断内容权重与结构,这决定了 h1 该唯一、结构该清晰。