主题
回顾 BOM与DOM 介绍(Day12 1/3)
本页对应 Day12_DOM,共 7 段视频,约 1 小时 37 分。
学习目标
- 能够区分 BOM 与 DOM 的操作对象,并列举 window 的常用属性、弹窗/滚动/定时器方法及定时器清除方式。
- 能够使用
scrollTo、scrollBy编写上一页、下一页和返回顶部效果,并说明滚动方向、距离及behavior: "smooth"的作用。 - 能够使用
setInterval与Date编写电子时钟,完成年月日时分秒获取、个位数补零,并说明回调内创建日期对象及首屏避免空白的原因。 - 能够解释 DOM、XML DOM 与 HTML DOM 的区别,说明 DOM 操作的核心是获取元素对象并操作对应页面元素。
- 能够识别 document、元素、属性、文本、注释五类节点,并使用
nodeName、nodeValue、nodeType判断节点类型及常见类型值。 - 能够使用
getElementById、getElementsByTagName、getElementsByClassName、getElementsByName获取元素,区分单个元素与类数组集合、空值与空集合,并能从指定元素后代中按标签名或类名获取元素。
知识点
先分清 BOM 与 DOM:操作对象不同
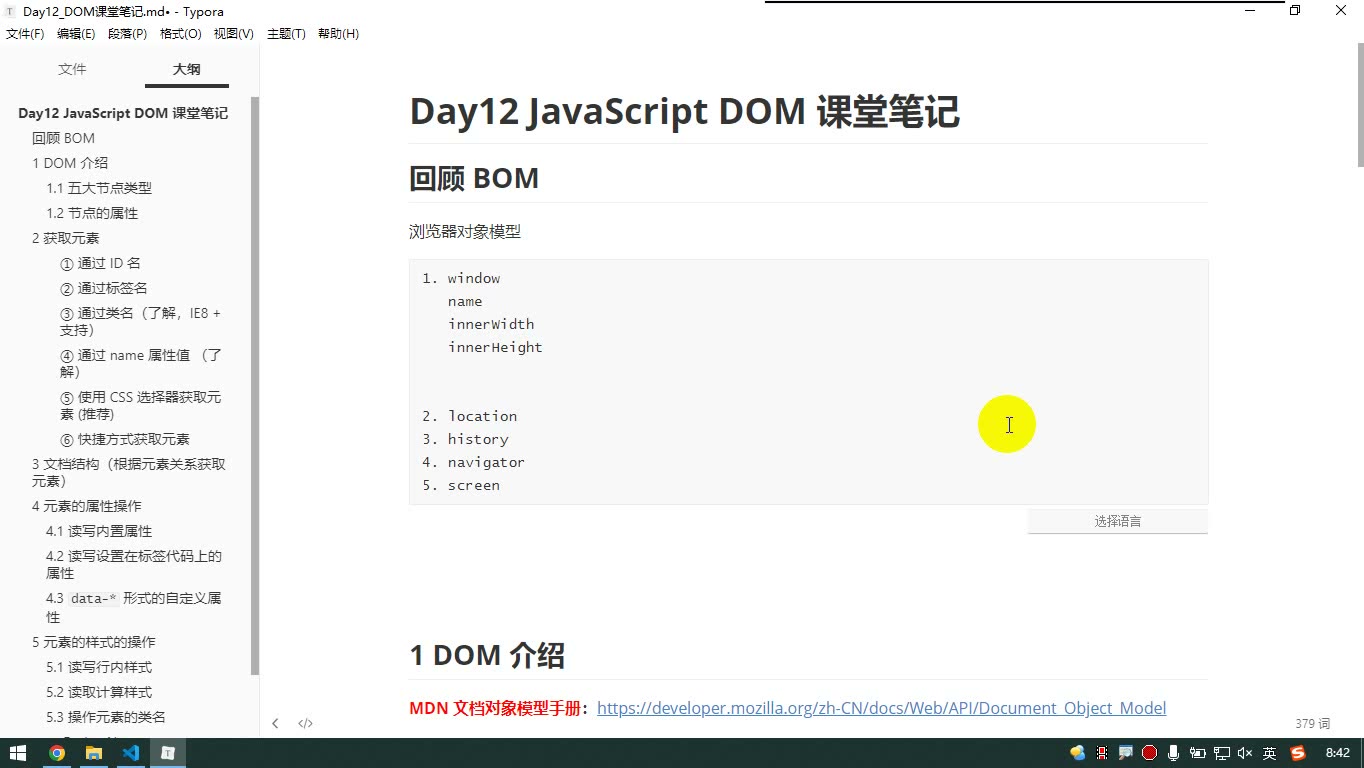
为什么需要:BOM 管浏览器窗口,DOM 管页面文档。转写稿先回顾 BOM,是为了避免把 window、location、history、navigator、screen 和 DOM 混在一起。
怎么想:window 是浏览器窗口对象,document 是窗口里的文档对象,所以 document 是 window 的属性;DOM 的入口通常就是 document。
怎么做:BOM 常关注弹窗、定时器、页面滚动、地址栏和历史记录;DOM 关注“获取元素、修改内容/样式、绑定事件”。
易错点:document 不是 BOM 那五个核心对象之一,它是 DOM 的文档对象;全局变量和内置构造函数前省略的往往是 window.。
DOM 的核心:用 JS 对象映射 HTML 元素
为什么需要:HTML 是静态结构,想让用户操作后内容或样式变化,就要用 JS 找到对应元素再修改。
怎么想:转写稿用“造个小人,扎它,本人会疼”作比喻:JS 中拿到一个对象,操作它,页面上对应元素就变化。DOM 操作的核心是“先获取元素对象,再操作对象”。
怎么做:document.getElementById('box') 拿到元素后,再改 innerHTML、style 或绑事件。
易错点:DOM 对象不是字符串;控制台里显示成类似标签的样子只是调试工具的表现。DOM 文档对象很多,但常用的是元素共有属性和方法,不要被数量吓住。
五种节点:一切皆节点,但元素最重要
为什么需要:DOM 把文档中的文档、元素、属性、文本、注释都视为节点,理解节点类型才能判断拿到的是什么。
怎么想:document 表示整个文档;元素要获取;属性和文本依附于元素;注释也在元素内部。
怎么做:
js
const el = document.getElementById('box');
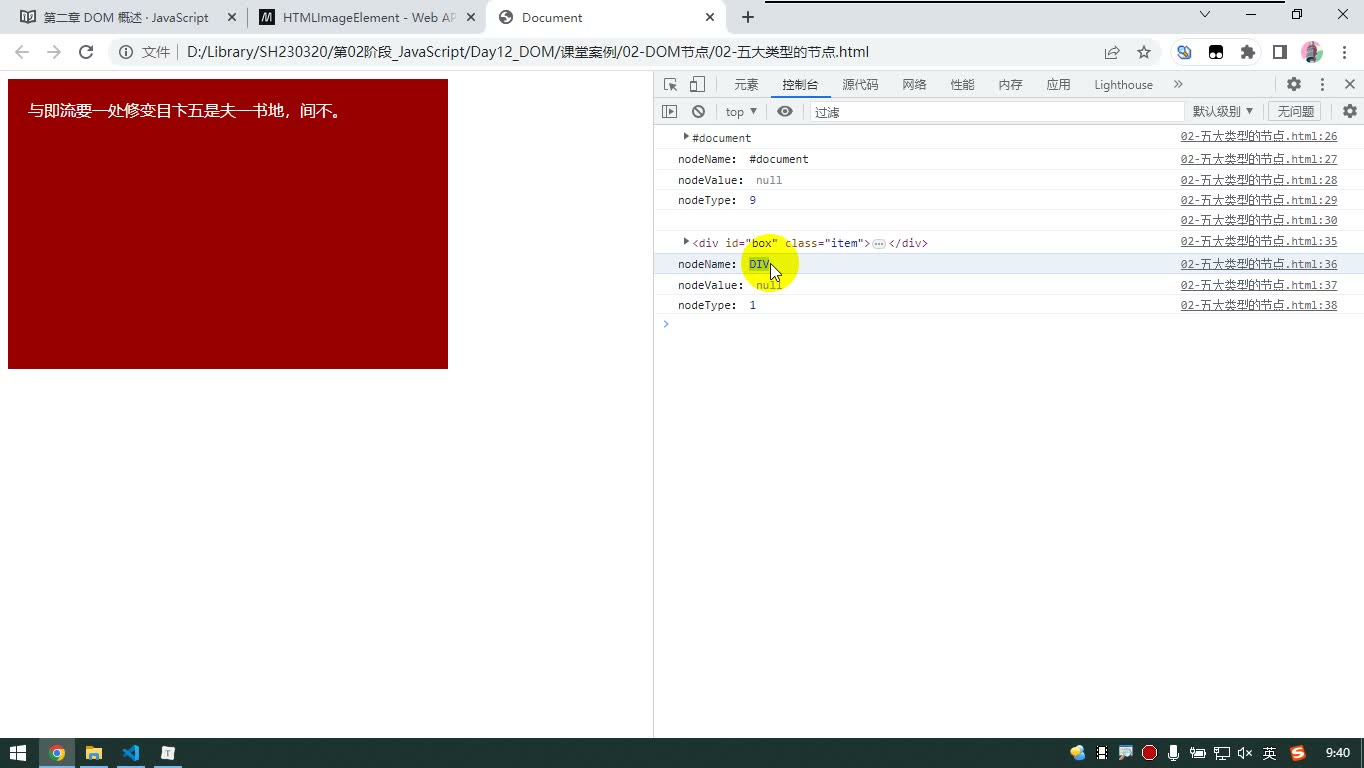
console.log(el.nodeName, el.nodeValue, el.nodeType); // DIV null 1常见 nodeType:文档 9、元素 1、属性 2、文本 3、注释 8。
易错点:不要死记所有 nodeName;元素节点的 nodeName 是标签名,最常用。属性、文本、注释节点在实际开发中通常不直接获取,元素才是重点。
通过 ID 获取元素:唯一、直接、可能返回 null
为什么需要:ID 在页面中应唯一,按 ID 找元素最直接。
怎么想:一个 ID 对应一个元素,所以返回单个元素对象。
怎么做:
js
const book01 = document.getElementById('book01');易错点:找不到时返回 null,不是空字符串;对 null 调属性会报错。getElementById 只有 document 有。
通过标签名获取元素:返回 HTMLCollection
为什么需要:同标签元素可能有很多,需要批量拿到。
怎么想:标签名不唯一,所以返回集合,不是单个元素。
怎么做:
js
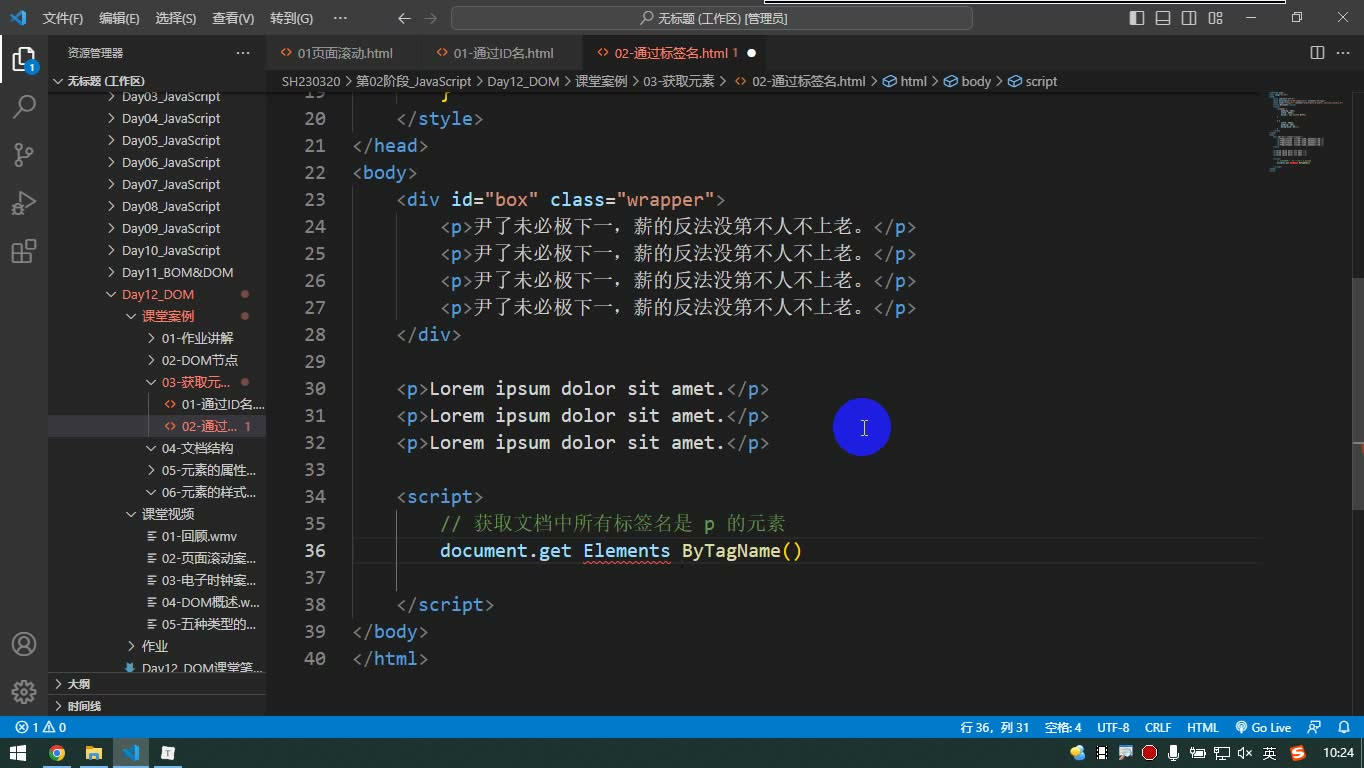
const ps = document.getElementsByTagName('p');
for (let i = 0; i < ps.length; i++) {
  ps[i].innerHTML = '第' + i + '个段落';
}也可从某个元素的后代中找:box.getElementsByTagName('p')。
易错点:返回 HTMLCollection,是类数组,不能直接 ps.innerHTML = ...;要 ps[0] 或遍历。找不到时仍返回空集合,不是 null。
通过类名和 name 获取元素:了解即可
为什么需要:类名可批量选元素;name 属性也常用于表单等场景。
怎么想:类名和 name 都可能重复,所以返回集合。
怎么做:
js
const items = document.getElementsByClassName('item');
const names = document.getElementsByName('xiao');getElementsByClassName 可从元素后代中找;getElementsByName 只有 document 有。
易错点:getElementsByClassName 返回 HTMLCollection,getElementsByName 返回 NodeList,二者都按类数组使用;找不到时返回空集合。转写稿强调这两种“了解即可”,实际更推荐后续更现代的获取方式。
两个案例的调试提醒:滚动与电子时钟
为什么需要:案例把 DOM 获取、事件、定时器串起来。
怎么想:滚动案例用 scrollBy 按视口高度滚动,返回顶部用 scrollTo({ top: 0, behavior: 'smooth' });电子时钟每隔 1 秒更新一次。
怎么做:
js
nextBtn.onclick = function () {
  window.scrollBy({ top: window.innerHeight, behavior: 'smooth' });
};时钟回调里必须每次 new Date(),不能在外边只创建一次;先手动执行一次函数,避免打开页面空白一秒。
易错点:scrollBy 正负方向写反就换符号试;定时器回调函数传名字时不要加括号;补零要处理个位数。
先把 BOM 和 DOM 分清
为什么需要:BOM 是浏览器对象模型(Browser Object Model),DOM 是文档对象模型(Document Object Model)。两者都叫“对象模型”,但操作对象不同:BOM 面向浏览器窗口、地址、历史、屏幕等;DOM 面向文档里的元素。转写稿里反复提醒:document 不是 BOM 的核心对象,它是 DOM 的入口,同时又是 window 的属性。
怎么想:先记住 BOM 的五个对象:window、location、history、navigator、screen。其中 window 最特殊,它是全局对象,很多全局变量和函数本质上是 window 的属性或方法,直接写时可以省略 window.。
怎么做:本节笔记的 BOM 清单要能对照使用:
js
1. window
   name
   innerWidth
   innerHeight
   alert()
   confirm()
   prompt()
   open()
   close()
   scrollTo()
   scrollBy()
   setInterval()
   clearInterval()
   setTimeout()
   clearTimeout()

2. location
   href
   protocol
   hostname
   port
   host
   pathname
   hash
   search
   reload()
   assign()
   replace()

3. history
   length
   back()
   forward()
   go()

4. navigator
   userAgent

5. screen
   width
height易错点:不要把 document 当成 BOM 的第六个对象;它是 window.document,是 DOM 操作的入口。window 的方法很多,重点先抓弹窗、滚动、定时器。
window:窗口、弹窗、滚动与定时器
为什么需要:页面运行在窗口里,窗口尺寸、弹窗、滚动位置、定时任务都要通过 window 控制。
怎么想:window.name 是窗口名字;innerWidth、innerHeight 是视口宽高。弹窗有 alert()、confirm()、prompt();open() 可打开新窗口并设置地址和尺寸,close() 关闭窗口。
怎么做:滚动有两个方法:scrollTo() 滚到指定坐标,scrollBy() 滚动指定距离。定时器分多次和单次:setInterval() 配 clearInterval(),setTimeout() 配 clearTimeout()。开启定时器会有返回值,即定时器标记,清除时要指定这个标记。
易错点:转写稿特别提醒,close() 一般只能关闭用 open() 打开的窗口;scrollTo()/scrollBy() 的坐标方向如果和直觉相反,不要死记,试一下,正负号不对就换过来。
滚动案例:scrollBy 和 scrollTo 的方向调试
为什么需要:做“上一页、下一页、返回顶部”时,需要让页面滚动到合适位置。
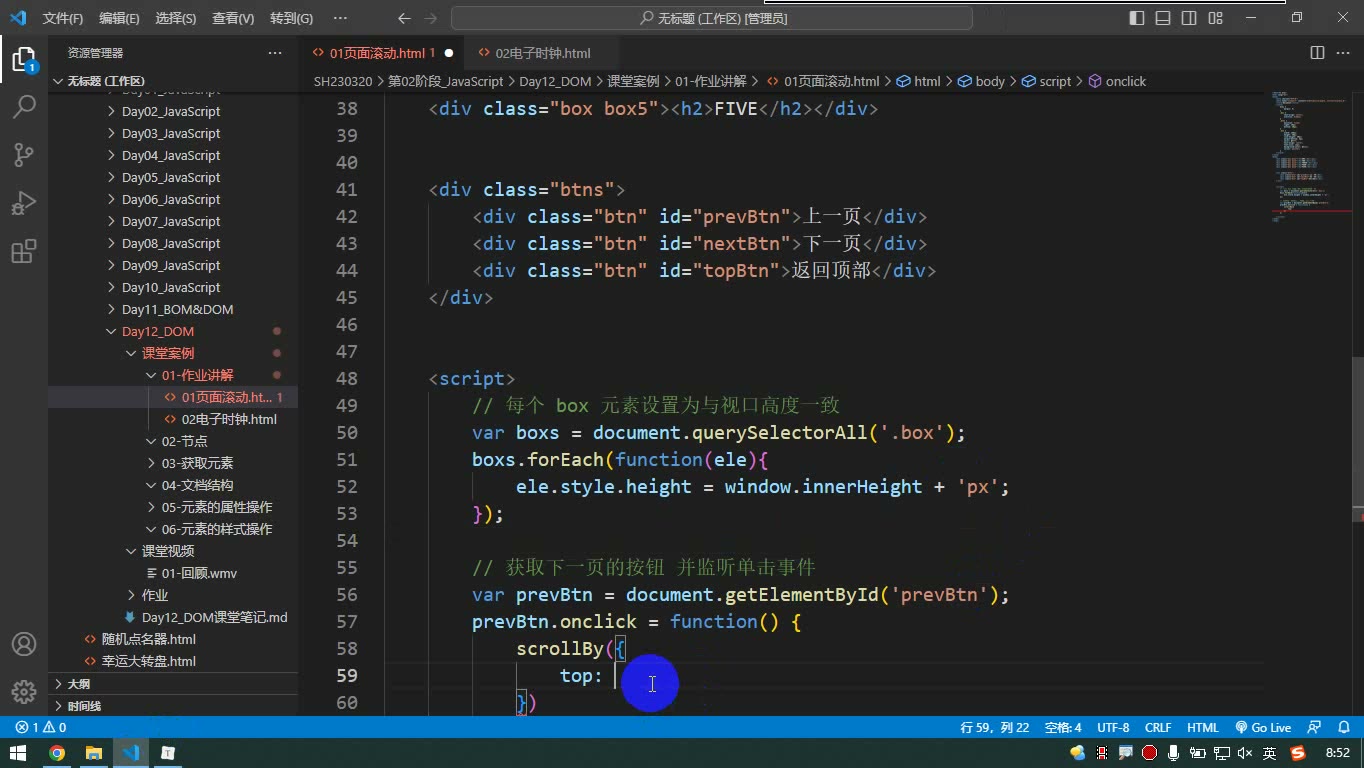
怎么想:每个区块高度设成视口高度,点“下一页”就向下滚一屏,点“上一页”就向上滚一屏;返回顶部则滚到 top: 0。转写稿里的调试过程很典型:一开始按钮 ID 写反了,注释写对但 ID 写错,改过来才生效;方向不对时加负号。
怎么做:下一页用 scrollBy({ top: window.innerHeight, behavior: 'smooth' });上一页把 top 改成负的 innerHeight;返回顶部用 scrollTo({ top: 0, behavior: 'smooth' })。
易错点:课堂里也说明,用户手动滚到中间后再点上一页/下一页,不一定刚好一屏,因为当时知识点还不够,不能实时获取当前滚动距离,所以案例先做到这个程度。不要把“方向记反”当核心,调试时试正负号即可。
电子时钟:定时器里每次 new Date
为什么需要:时钟要每秒变化,必须用定时器反复执行。
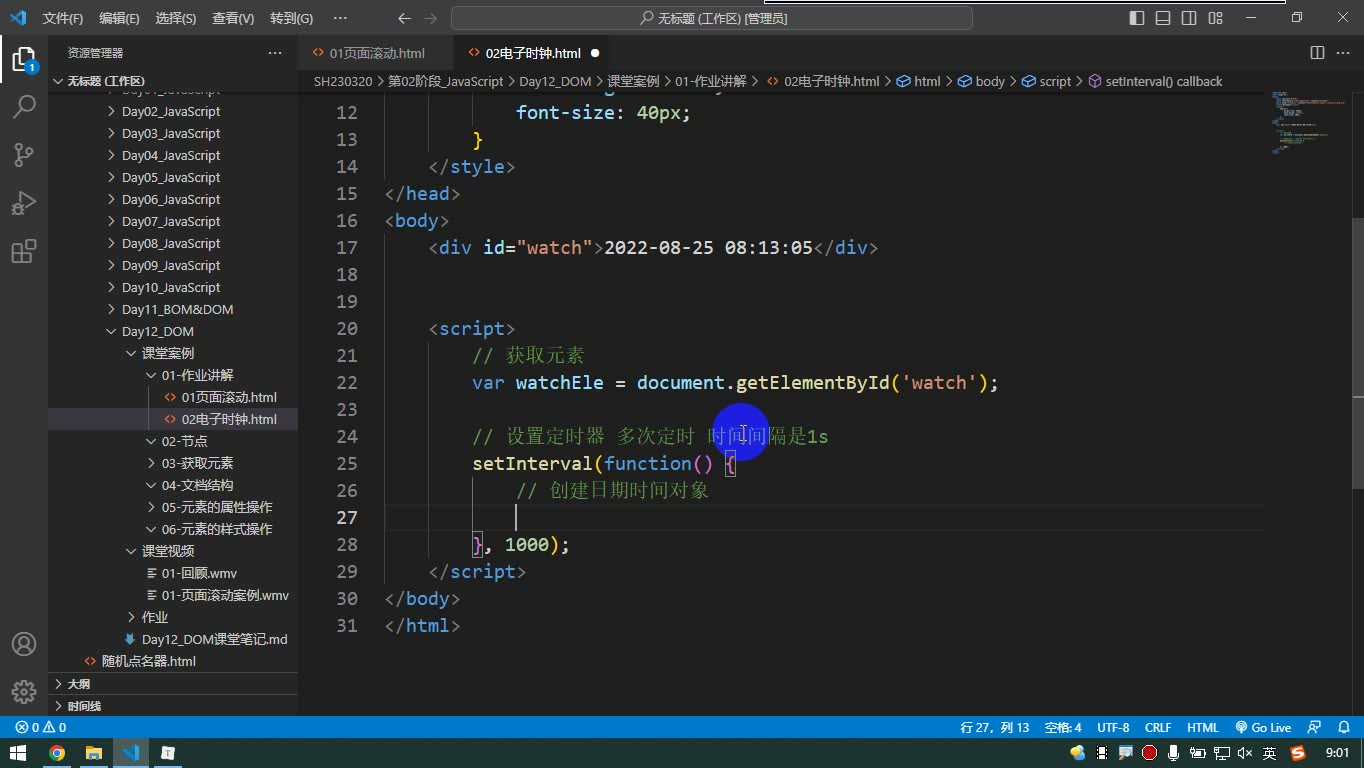
怎么想:关键是 new Date() 要放在定时器回调函数内部。转写稿里专门追问:日期对象放外面还是里面?放外面只创建一次,时间是死的,定时器白定;放里面才会每次拿到当前时间。
怎么做:用 setInterval(runTime, 1000),回调里创建日期对象,取年、月、日、时、分、秒;月要 +1;个位数补零;最后拼接字符串赋给元素的 innerHTML。第一次打开页面会空白一秒,因为回调一秒后才执行,所以把函数命名为 runTime,先手动调用一次 runTime(),再交给 setInterval。
易错点:setInterval(runTime, 1000) 不要写成 runTime(),否则是立即执行并把返回值交给定时器;new Date() 不要放外面;补零和字符串拼接要仔细,转写稿里就出现过变量重复、写两遍的小问题。
location:读 URL 与控制跳转
为什么需要:页面地址信息要读取,也常用 JS 控制跳转。
怎么想:href 是完整 URL;protocol、hostname、port、host、pathname、hash、search 是其中一部分。改 href 等会让页面跳转;改 hash、search 只改 URL 上的锚点或参数信息,不会让页面跳转。
怎么做:reload() 重新加载;assign() 正常跳转并留下历史记录;replace() 跳过去不留下历史记录,回不来。
易错点:replace() 适合不想让用户回退的场景,别和 assign() 混用。
history、navigator、screen
为什么需要:history 管本窗口历史记录,navigator 可看浏览器信息,screen 看屏幕尺寸。
怎么做:history.length 读数量,back() 上一个,forward() 下一个,go() 用数字指定。navigator.userAgent 常用于判断浏览器信息。screen.width、screen.height 是屏幕宽高。
易错点:history 是本窗口的历史记录,不是整个浏览器的历史;screen 不是视口尺寸,视口要看 window.innerWidth/innerHeight。
先分清 BOM 与 DOM
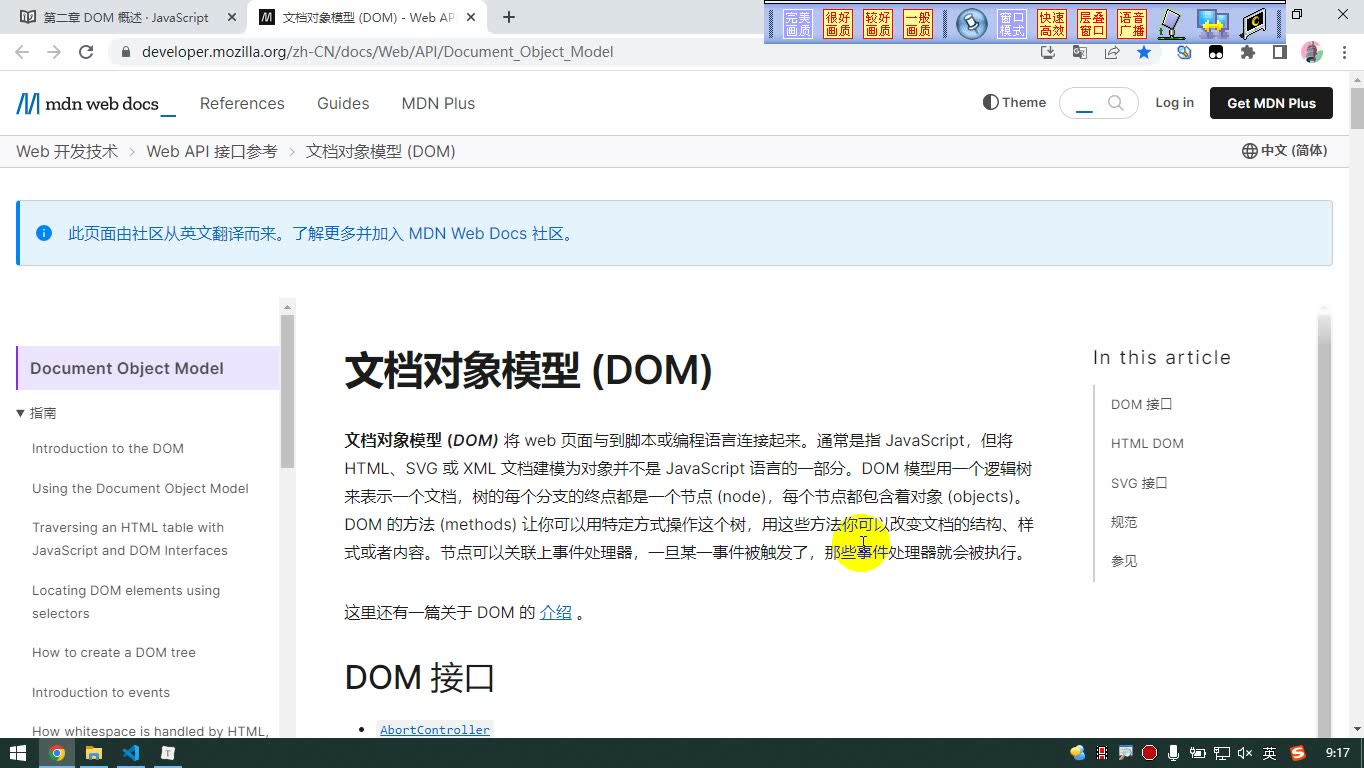
本节参考:MDN 文档对象模型手册:https://developer.mozilla.org/zh-CN/docs/Web/API/Document_Object_Model
为什么需要: 初学 DOM 很容易把 BOM 和 DOM 混在一起。转写稿里先回顾 BOM,是为了说明二者操作对象不同:BOM 的核心是 window,document 只是 window 的一个属性;DOM 的核心是 document 所代表的整个 HTML 文档。
怎么想: 先记一句话:BOM 管浏览器窗口,DOM 管页面文档。window 下有 location、navigator、screen、history、document 等;DOM 则把 HTML 文档中的元素、属性、文本、注释等组织成可被 JS 操作的对象。
怎么做: 在控制台分别输出 window 和 document,观察结构;再输出 document.nodeName、document.nodeType,先建立“document 也是对象、也是节点”的直观认识。
易错点: 不要把 document 当成 BOM 的独立对象;它是 window.document。也不要因为 window 的方法多,就把 DOM 操作和 BOM 操作混写。
DOM 是什么,为什么要学
为什么需要: 只有 HTML/CSS 时,页面是“死”的;用户点击、输入、滚动后页面要变化,就需要 JS 通过 DOM 去读写页面。
怎么想: DOM 是 Document Object Model,即文档对象模型。它的核心不是“背接口”,而是建立“JS 对象”和“HTML 元素”的一对一关联:在 JS 中操作对象,页面对应元素就变化。转写稿把它比作“造个小人,扎它本人会疼”。
怎么做: 先获取元素,再修改内容或样式。例如:
js
const box = document.getElementById("box");
box.innerHTML = "内容变了";
box.style.backgroundColor = "#f00";易错点: MDN 上 DOM 接口非常多,不要被吓住。实际入门先掌握“获取元素—操作元素”,不要一开始逐个背接口。
DOM 的组成与分级
为什么需要: 理解 XML DOM 与 HTML DOM,能解释为什么 MDN 上既有“所有元素共有”的接口,又有 HTMLDivElement、HTMLLIElement 等专门接口。
怎么想: 从 XML DOM 角度看,div、p、h1 都是“元素”,共有 nodeName、nodeType 等特性;从 HTML DOM 角度看,不同标签名元素又有各自特性。DOM Level 0/1/2/3 是版本分级,了解即可,现代开发不必过度纠结兼容性。
怎么做: 看 MDN 时先找 Node、Element、Document 这类“共有描述”,再看具体 HTMLDivElement 等。
易错点: 不要把 nodeName 的所有取值都死记;重点记元素节点的 nodeName 是标签名。DOM 分级也不是 HTML 版本号。
DOM 树与五种常用节点
为什么需要: DOM 把文档中所有内容都看作节点。要判断“拿到的是什么”,就要认识节点类型。
怎么想: HTML 中常用五类节点:document(9)、元素(1)、属性(2)、文本(3)、注释(8)。nodeType 不连续,是因为 DOM 还定义了其他类型,但 HTML 中常用就这几类。元素节点最重要,DOM 操作绝大多数都在操作元素。
怎么做: 可用下面代码观察:
html
<div id="box" class="item">二十个字<!-- hello world 我是注释 --></div>js
const ele = document.getElementById("box");
console.log(ele.nodeName, ele.nodeValue, ele.nodeType); // DIV, "", 1

const attr = ele.getAttributeNode("class");
console.log(attr.nodeName, attr.nodeValue, attr.nodeType); // class, item, 2

const text = ele.firstChild;
console.log(text.nodeName, text.nodeValue, text.nodeType); // #text, 二十个字, 3

const comment = ele.childNodes[1];
console.log(comment.nodeName, comment.nodeValue, comment.nodeType); // #comment, hello world 我是注释, 8易错点: 转写稿现场出现过 childNodes 少写 s 的报错,说明调试时要看清属性名。属性、文本、注释节点实际开发很少直接获取,因为有 getAttribute、innerHTML 等更方便方式;重点仍是元素。
获取元素:通过 id 和标签名
为什么需要: 要操作元素,先得拿到元素对象。getElementById 和 getElementsByTagName 是最古老、存量代码中最常见的方式。
怎么想: id 理论上唯一,所以返回单个元素或 null;标签名可能多个,所以返回 HTMLCollection 类数组集合,集合成员才是元素。
怎么做:
js
const book01 = document.getElementById("book01"); // 找不到返回 null

const ps = document.getElementsByTagName("p");
for (let i = 0; i < ps.length; i++) {
  ps[i].innerHTML = "第" + i + "个段落" + Math.random();
}

const box = document.getElementById("box");
const ps2 = box.getElementsByTagName("p");
ps2[ps2.length - 1].style.backgroundColor = "#f00";易错点: getElementsByTagName 返回集合,不能直接写 ps.innerHTML,要索引或遍历。找不到时它仍返回空集合,不是 null;而 getElementById 找不到返回 null。转写稿还演示过 id 写反、滚动方向写反,调试时先检查选择器和参数。
获取元素:类名和 name 属性值
为什么需要: 类名可批量选元素;name 属性常用于表单等场景。它们要“了解”,因为存量代码可能出现,但初学不推荐作为首选。
怎么想: 类名和 name 都可能重复,所以返回集合。getElementsByClassName 既可从 document 调用,也可从某个元素的后代中调用;getElementsByName 只有 document 上有,返回 NodeList。
怎么做:
js
const items = document.getElementsByClassName("item"); // HTMLCollection
const box = document.getElementById("box");
const items2 = box.getElementsByClassName("item"); // 只在 box 后代中找

const names = document.getElementsByName("小燕"); // NodeList易错点: HTMLCollection 和 NodeList 都是类数组,不能直接当元素操作,要用索引或遍历。getElementById 只有 document 有;getElementsByName 也只有 document 有。转写稿提醒:这两类方法“了解即可”,后续还有更先进的获取方式,但读旧代码时必须认识。
课堂画面
代码示例
示例一:电子时钟(定时器 + Date + 补零)
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>电子时钟</title>
  <style>
    #watch { font-size: 32px; font-family: Consolas, monospace; color: #333; }
  </style>
</head>
<body>
  <div id="watch"></div>

  <script>
    // 1. 元素只获取一次,后面反复使用
    var watchEle = document.getElementById('watch');

    // 2. 把回调抽成有名字的函数,才能"传函数名不传函数调用"
    function runTime() {
      // 关键:Date 必须在回调内部创建,每次执行才是"当前时刻"
      var date = new Date();

      var y = date.getFullYear();   // 年
      var M = date.getMonth() + 1;  // 月:0~11,必须 +1
      var D = date.getDate();       // 日
      var H = date.getHours();      // 时
      var I = date.getMinutes();    // 分(不用 m,避免和月份变量重名)
      var S = date.getSeconds();    // 秒

      // 3. 个位数补零
      if (M < 10) M = '0' + M;
      if (D < 10) D = '0' + D;
      if (H < 10) H = '0' + H;
      if (I < 10) I = '0' + I;
      if (S < 10) S = '0' + S;

      // 4. 字符串拼接后写回元素内容
      watchEle.innerHTML = y + '-' + M + '-' + D + ' ' + H + ':' + I + ':' + S;
    }

    // 5. 开启多次定时器,间隔 1000ms,传函数名(不加括号)
    setInterval(runTime, 1000);

    // 6. 手动先执行一次,避免打开页面后空白一秒
    runTime();
  </script>
</body>
</html>要点解释
setInterval(runTime, 1000)传的是函数名,加了括号就变成"立即执行一次并把返回值传进去",定时器会失效。new Date()写在回调函数内部:写在外面只创建一次,时间是固定的,定时器等于白定。getMonth()返回 0~11,必须 +1;月份变量用M、分钟用I,防止重名覆盖。- 补零用
if (x < 10) x = '0' + x,注意赋值后是字符串,后面拼接才不出错。 - 最后
runTime()手动调用一次,解决"打开页面空白一秒"的易错点;调用时可以加括号,因为这里是主动执行。
示例二:上一页 / 下一页 / 返回顶部(scrollBy 与 scrollTo)
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>页面滚动</title>
  <style>
    * { margin: 0; padding: 0; }
    .page {
      height: 100vh;            /* 高度动态取视口高度,不是写死的 */
      font-size: 60px;
      text-align: center;
      line-height: 100vh;
      color: #fff;
    }
    .page:nth-of-type(1) { background: #e74c3c; }
    .page:nth-of-type(2) { background: #3498db; }
    .page:nth-of-type(3) { background: #2ecc71; }
    .page:nth-of-type(4) { background: #9b59b6; }
    .btns { position: fixed; right: 20px; bottom: 40px; }
    .btns button { padding: 8px 16px; margin-left: 8px; cursor: pointer; }
  </style>
</head>
<body>
  <div class="page">第 1 屏</div>
  <div class="page">第 2 屏</div>
  <div class="page">第 3 屏</div>
  <div class="page">第 4 屏</div>

  <div class="btns">
    <button id="prev">上一页</button>
    <button id="next">下一页</button>
    <button id="top">返回顶部</button>
  </div>

  <script>
    var prevBtn = document.getElementById('prev');
    var nextBtn = document.getElementById('next');
    var topBtn  = document.getElementById('top');

    // 下一页:向下滚动一屏
    nextBtn.onclick = function () {
      window.scrollBy({
        top: window.innerHeight,   // 正数向下,距离正好一屏
        behavior: 'smooth'         // 带滚动效果
      });
    };

    // 上一页:向上滚动一屏
    prevBtn.onclick = function () {
      window.scrollBy({
        top: -window.innerHeight,  // 负数向上
        behavior: 'smooth'
      });
    };

    // 返回顶部:滚到指定坐标 (0,0),不是"滚动多少"
    topBtn.onclick = function () {
      window.scrollTo({
        top: 0,
        behavior: 'smooth'
      });
    };
  </script>
</body>
</html>要点解释
scrollBy是"滚动指定距离",scrollTo是"滚动到目标坐标",返回顶部必须用scrollTo({ top: 0 })。- 每屏高度用
100vh/window.innerHeight动态计算,和滚动距离保持一致,才不会错位。 - 方向反了就把
top的正负号换一下,不用死记;横向不滚动就不写left。 - 易错点:用户手动滚到半屏再点上下页,会滚得不整齐。这是因为本节知识点还无法获取当前滚动距离,暂时不处理这种意外情况。
示例三:获取元素 + 五种节点类型(nodeName / nodeValue / nodeType)
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>获取元素与节点类型</title>
  <style>
    #box { width: 400px; height: 250px; margin: 20px; background: red; color: #fff; }
    .wrap { padding: 20px; width: 600px; background: #eee; border: 1px dashed #900; }
    .wrap p, .wrap div.item { width: 500px; margin: 20px; background: #ccc; }
  </style>
</head>
<body>
  <!-- 注意:文本和注释写在同一行,避免换行产生多余的空白文本节点 -->
  <div id="box" class="item" name="xiaole">这是二十个字<!-- hello world 我是注释 --></div>

  <div class="wrap" id="books">
    <p class="item" name="xiaole">段落1</p>
    <p class="item">段落2</p>
    <div class="item" name="xiaole">段落3</div>
    <p>段落4</p>
  </div>

  <p class="item" name="xiaole">外面的P</p>

  <script>
    /* ---------- 一、五种节点类型:nodeName / nodeValue / nodeType ---------- */
    console.log(document.nodeName, document.nodeValue, document.nodeType);   // #document null 9

    var box = document.getElementById('box');           // 找不到时返回 null
    console.log(box.nodeName, box.nodeValue, box.nodeType);                   // DIV null 1

    var attrNode = box.getAttributeNode('class');       // 属性依附于元素,必须先拿元素
    console.log(attrNode.nodeName, attrNode.nodeValue, attrNode.nodeType);    // class item 2

    console.log(box.firstChild.nodeName, box.firstChild.nodeValue, box.firstChild.nodeType);
    // #text 这是二十个字 3

    var commentNode = box.childNodes[1];                // [0] 是文本,[1] 才是注释
    console.log(commentNode.nodeName, commentNode.nodeValue, commentNode.nodeType);
    // #comment hello world 我是注释 8

    /* ---------- 二、通过标签名获取(返回 HTMLCollection 类数组) ---------- */
    var pEles = document.getElementsByTagName('p');     // 全文档所有 p
    for (var i = 0; i < pEles.length; i++) {
      pEles[i].innerHTML = '第' + i + '个段落' + Math.random();
    }

    /* ---------- 三、从某个元素的后代中获取(缩小范围) ---------- */
    var books = document.getElementById('books');
    var itemEles = books.getElementsByClassName('item'); // 只找 books 后代里的 item
    console.log(itemEles.length);                        // 3
    itemEles[itemEles.length - 1].style.backgroundColor = '#f00'; // 取最后一个改背景

    /* ---------- 四、通过 name 属性值获取(返回 NodeList) ---------- */
    var nameEles = document.getElementsByName('xiaole'); // 只有 document 有这个方法
    console.log(nameEles.length);                        // 4
  </script>
</body>
</html>要点解释
nodeType记忆口诀:文档 9、元素 1、属性 2、文本 3、注释 8;4/6/7/10/11 属于 XML 等场景,HTML 中基本用不到。nodeName:只有元素节点返回标签名(DIV),其他都是#document、#text、#comment这种带#的形式;nodeValue只有属性、文本、注释有值,其余为null。getElementById只有 document 有,找不到返回null,再调用属性方法就会报错。getElementsByTagName/getElementsByClassName元素对象也有,可从后代中缩小范围;找不到返回空集合,不是null。getElementsByName返回的是NodeList,其余两个返回HTMLCollection,两者都是类数组,不能直接innerHTML,必须先[索引]取成员或用for遍历。- 易错点:HTML 里文本、注释之间换行会多出空白文本节点,导致
childNodes[1]不是注释,演示时把标签写成一行。
常见错误
方法名单复数、大小写混用 现象:控制台报
document.getElementByTagName is not a function,或拿到undefined。 原因:四个获取方法里只有getElementById是单数Element,其余三个都是复数Elements;Id的I必须大写。 修法:取一个用Element,取一堆用Elements;报这类错时先逐字符核对方法名,别急着怀疑选择器或页面结构。对着集合直接赋值 现象:
document.getElementsByTagName('p').innerHTML = 'xxx'页面毫无反应,也不报错。 原因:拿到的是HTMLCollection/NodeList(类数组),不是元素;给集合设innerHTML只是给它挂了个没用的属性。 修法:先用console.log看清拿到的是元素还是集合(带HTMLCollection字样、能展开出 0/1/2…),再决定用索引[0]取成员或for循环遍历。在 null 上取属性 现象:
Cannot read properties of null (reading 'innerHTML')。 原因:getElementById找不到时返回null;script写在head里、元素还没解析出来时也是null。注意集合类方法不会返回null,只会返回空集合,两者容易混淆。 修法:操作前判空;把script放到body末尾;调试期先console.log元素确认拿到了。在定时器外面
new Date()现象:时钟显示的时间永远停在打开页面那一刻,秒数不动。 原因:Date实例只创建了一次,回调每次读的都是同一个"死"对象。 修法:把new Date()放进回调内部,每次执行都重新取当前时间。setInterval(runTime(), 1000)现象:函数立刻执行一次,然后定时器再无动静。 原因:加了括号是"调用函数",传给定时器的是返回值undefined。 修法:传函数名本身不加括号;需要传参就用箭头函数包一层。同时首屏要手动调一次runTime(),否则页面会空白一秒。scrollTo参数与方向写错 现象:点"下一页"页面不动,或方向反了;传纯数字没反应。 原因:现代写法要传对象{ top, left, behavior };正负方向与直觉相反;behavior拼错会静默退化为瞬间跳转。 修法:统一用对象写法,纵向距离取±innerHeight,方向不对就换符号试一次,别背;behavior: 'smooth'逐字核对。
练习
四方法对照实验:写一个含 6 个
p、2 个div、其中部分带class="item"和name属性的页面,分别用getElementById、getElementsByTagName、getElementsByClassName、getElementsByName获取,把每次结果的构造函数名、length、能否直接forEach打印成一张对照表,并注明哪几个可能返回null。找 bug 并修复:下面这段代码有三处问题,找出全部并说明原因,然后改对——
jsconst clock = document.getElementById('clock'); const now = new Date(); setInterval(function () { clock.innerHTML = now.getHours() + ':' + now.getMinutes() + ':' + now.getSeconds(); }, 1000);滚动按钮组:用
scrollBy/scrollTo实现"下一页 / 上一页 / 返回顶部"三个按钮。完成后回答:为什么在页面最顶端连点"上一页"不会报错但也看不出效果?在现有知识点下你能否判断"已经到顶了"?如果暂时不能,说明缺少什么能力。电子时钟:实现一个每秒刷新的时钟,要求首屏打开就有内容、时分秒个位数自动补零、刷新过程无闪烁。把时间格式化逻辑抽成一个具名函数,分别用于首屏手动调用和定时器。
节点类型探测器:写一个函数
describe(node),用nodeType判断并返回中文类型名,测试传入document、一个元素、getAttributeNode('class')、firstChild、第二个子节点(注释),并说明为什么其中三种在日常开发中几乎用不到。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 回顾 | 08:00 |
| 2 | 页面滚动案例 | 06:22 |
| 3 | 电子时钟案例 | 09:43 |
| 4 | DOM概述 | 16:29 |
| 5 | 五种类型的节点 | 28:31 |
| 6 | 获取元素-通过id和标签名 | 18:38 |
| 7 | 获取元素-通过类名和name属性值 | 09:48 |
小结
- DOM 操作的主线永远是"先拿到元素对象,再改它的属性、内容或样式";BOM 那五个对象里只有
window是全局对象本身,其余都是它的属性。 - 五种节点中只有元素节点(
nodeType为 1)是日常主战场;属性、文本、注释节点知道它们存在即可,实际开发有更顺手的替代写法。 - 判断要不要判空,看方法返回值:单数方法返回元素或
null,复数方法永远返回集合,最差也是空集合——所以null判断只对getElementById有意义。 - 集合不能当元素用,索引或遍历取成员;
getElementsByClassName/ByName只能挂在document上,getElementsByTagName可以挂在元素上用来缩小范围。 - 定时器的三条铁律:数据要在回调内部取、传函数名不加括号、首屏手动执行一次。
scrollTo/scrollBy用对象参数 +behavior,方向靠试不靠背;scrollTo({top: 0})天然比锚点跳转体验好。- 目前拿不到"当前滚动距离",所以上一页/下一页在边界处会失效,这是知识点的已知缺口,不是代码写错——后续课程补上后再回来处理。