主题
DOM 介绍与获取元素(Day12 2/3)
本页对应 Day12_DOM,共 7 段视频,约 1 小时 20 分。
学习目标
- 能使用
querySelector获取第一个匹配元素、使用querySelectorAll获取所有匹配元素集合,并说明无匹配时分别返回null和空集合。 - 能通过
document.documentElement、document.body、document.all快捷获取特殊元素或元素集合,并利用document.all的布尔转换结果说明其判断旧 IE 的适用范围。 - 能解释“JS 会自动创建与 ID 同名变量”的现象,并在代码中避免依赖该非标准写法。
- 能使用
children、firstElementChild、lastElementChild、parentElement、previousElementSibling、nextElementSibling根据元素关系获取子元素、父元素和兄弟元素。 - 能区分内置属性与自定义属性,并使用“元素对象.属性名”正确读写内置属性。
- 能使用
getAttribute和setAttribute读取、设置标签代码上的属性,并说明其不区分内置与自定义属性、未写入代码时读取为null的规则。
知识点
DOM 与 CSS 选择器获取元素
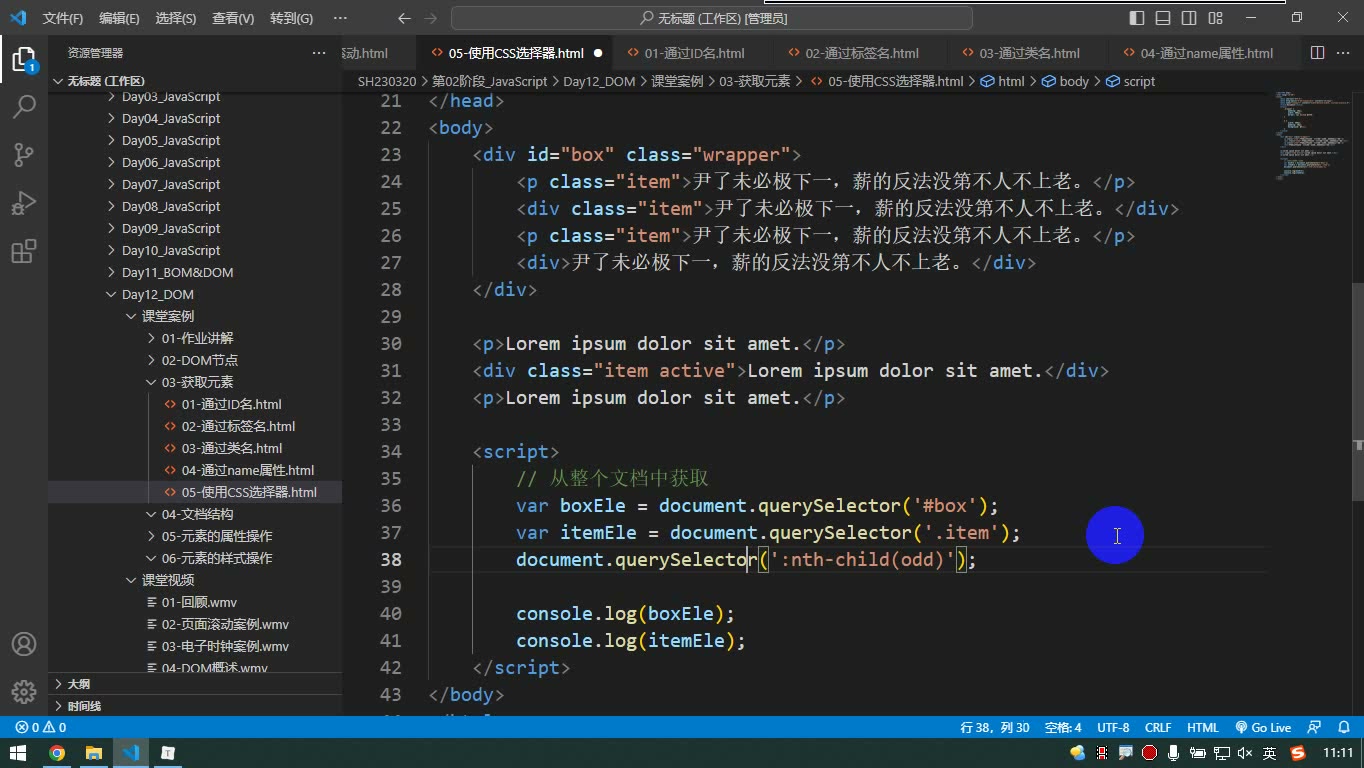
本节笔记标题是“DOM 介绍”,笔记中保留了 MDN 的文档对象模型手册链接:MDN 文档对象模型手册。学习 DOM 的第一步,是先把 HTML 中的元素拿到 JavaScript 里。为什么需要?因为只有先获取到元素对象,后面才能改内容、改样式、绑事件。怎么想?转写稿里反复强调:CSS 选择器本来就是“选元素”的,而且“指哪打哪”,所以 JavaScript 也提供了用 CSS 选择器获取元素的方法。怎么做?核心是两个方法:querySelector 和 querySelectorAll。querySelector 返回符合条件的第一个元素;querySelectorAll 返回所有符合条件的元素组成的集合,通常是 NodeList。它们既可以从整个文档获取,也可以从某个元素的后代中获取。示例:
js
const bookEle = document.querySelector('#books');
console.log(bookEle);

const itemEle = document.querySelector('.item'); // 只拿第一个
const itemList = document.querySelectorAll('.item'); // 拿所有,集合也可以写复杂选择器,例如 document.querySelector('.wrapper p:nth-child(odd)'),表示在 .wrapper 后代中找奇数位置的 p。易错点:querySelector 永远只返回第一个,不会因为你有多个就全给你;querySelectorAll 永远返回集合,即使只有一个或一个都没有,也是集合,没有匹配就是空集合。转写稿还提醒:获取到的结果无非两类——单个元素或集合;集合要遍历或用索引取。
快捷方式:documentElement、body 与 document.all
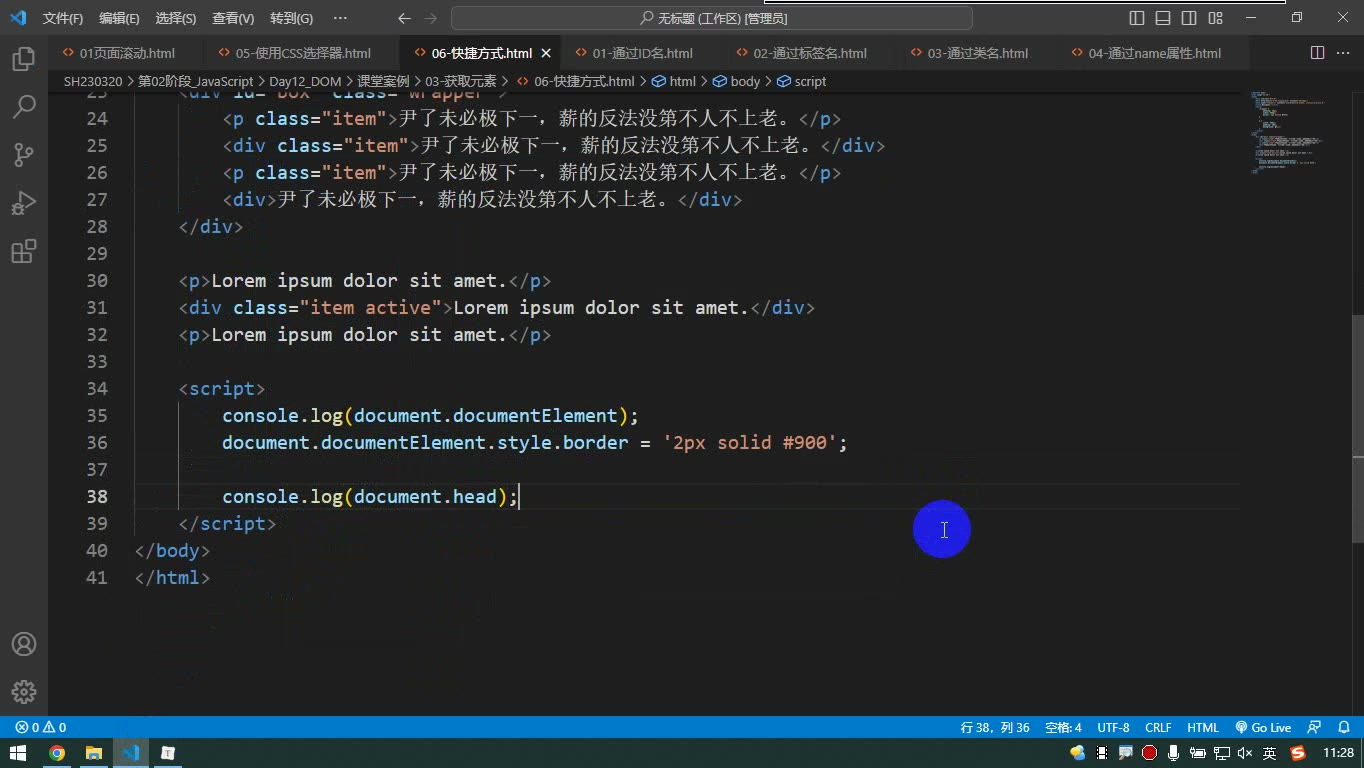
为什么需要?像 html、body 这种在文档中很特殊的元素,如果每次都写选择器会啰嗦。怎么想?既然它们特殊,就可以给快捷方式。怎么做?document.documentElement 获取 html 元素,document.body 获取 body 元素。转写稿中还给 html、body 加边框验证,检查元素时能看到行内样式。代码:
js
console.log(document.documentElement);
document.documentElement.style.border = '2px solid red';

console.log(document.body);
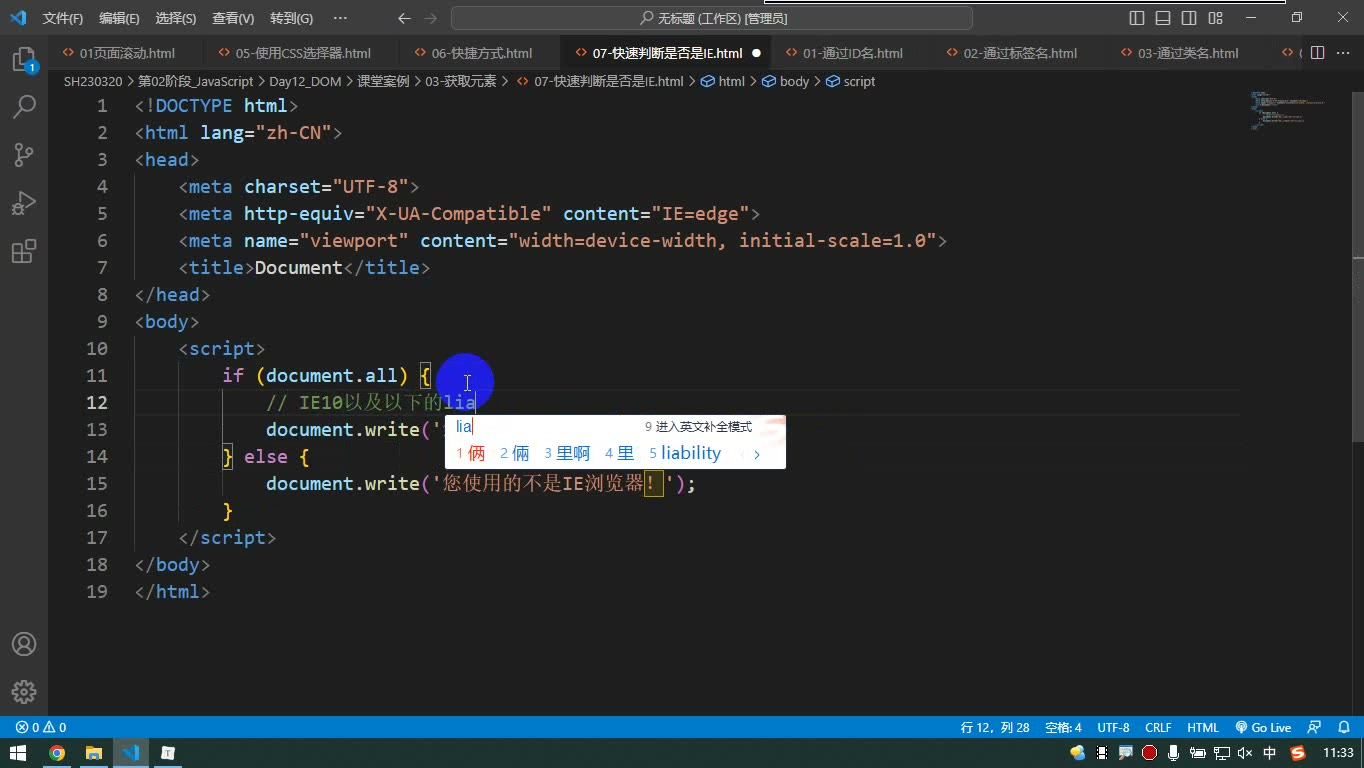
document.body.style.border = '2px solid green';document.all 可获取文档中所有元素组成的集合。转写稿演示输出 17 个,并说明它也是集合、类数组。易错点:document.all 有一个特殊现象——它有值,但转成布尔值时是 false。转写稿用 if (document.all) 做 IE 快速判断:成立时输出 IE 浏览器,不成立时输出非 IE;并说明 IE11 在这个判断里会走到“非 IE”分支。这里要记住:这是特殊行为,不要按“有值就是 true”去推。
与 ID 同名的变量:知道即可,不建议使用
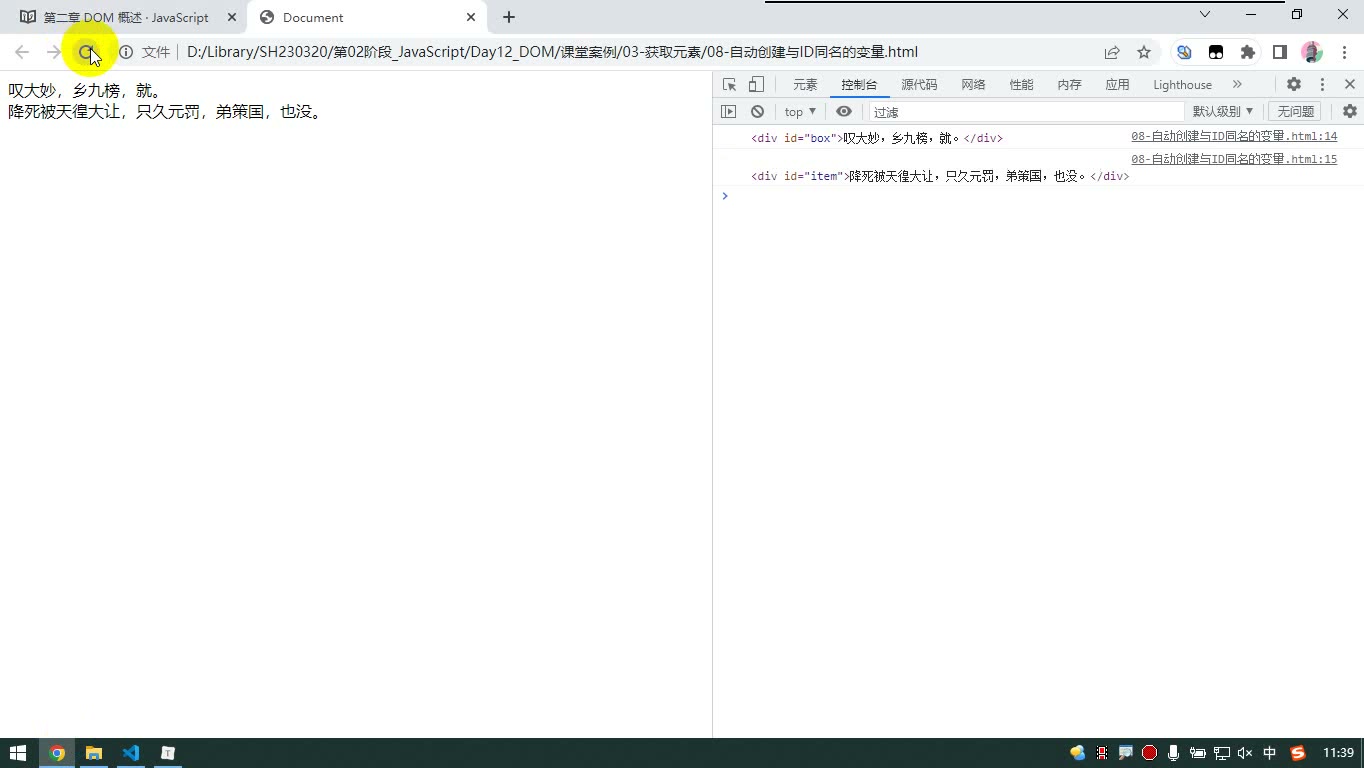
为什么需要?转写稿说这是 JavaScript 的一个特殊现象:HTML 中有 ID,JavaScript 中可能自动创建与 ID 同名的变量。怎么想?这不是我们主动声明变量,而是浏览器行为。怎么做?例如页面有 id="books",不写 getElementById,直接输出 books 也可能拿到该元素。易错点:转写稿明确说不建议这么干,因为可读性不好,也不符合“变量要用时先创建”的编程习惯;知道现象即可,开发中还是老老实实获取元素。
根据文档结构获取元素:节点与元素要分清
为什么需要?已经拿到某个元素后,常常还要操作它的父元素、子元素、兄弟元素;如果重新用选择器找,麻烦。怎么想?DOM 文档结构有两种表述:节点树和元素树。节点树包括文本节点、注释节点、属性节点等;元素树只考虑元素。转写稿用 children 演示:一个 div 里写了 6 个 p,但 children 若用节点方式会得到 13 个,因为 p 与 p 之间的换行也被当成文本节点。怎么做?实际开发优先用元素关系:
js
const booksEle = document.getElementById('books');
console.log(booksEle.children); // 所有子元素,HTMLCollection
console.log(booksEle.firstElementChild); // 第一个子元素
console.log(booksEle.lastElementChild);  // 最后一个子元素
console.log(booksEle.parentElement);     // 父元素
console.log(booksEle.previousElementSibling); // 上一个兄弟元素
console.log(booksEle.nextElementSibling); // 下一个兄弟元素易错点:children 是子元素集合,不是子节点集合;childNodes 会把换行文本也算进去。获取兄弟元素要用 previousElementSibling、nextElementSibling,不要用会拿到文本节点的旧属性。转写稿还演示了给第三个子元素设置 text-decoration,说明拿到元素后可直接操作样式。
读写内置属性:点语法映射
为什么需要?HTML 标签在标准中有很多属性,例如 img 的 src、alt、width、height,以及 id、class、title 等全局属性。怎么想?元素拿到 JavaScript 中变成对象后,标准属性会映射成对象属性,所以可以用点语法读写。怎么做?
js
const imageBox = document.querySelector('img');
console.log(imageBox.src);
console.log(imageBox.alt);
console.log(imageBox.width);
imageBox.src = './images/poker.jpg';
imageBox.width += 50;转写稿调试发现:src 写的是相对路径,读出来会被解析成绝对路径,中文还可能被编码;width 读出来是数字;没写 height 也能读到,因为标准属性存在,未写时可能是空字符串或默认值。易错点:内置属性会做特殊处理,例如 checked、selected、disabled 这类不需要写值的属性,映射后常是布尔值。复选框示例中,checkbox.checked 可读可改,甚至可写 checkbox.checked = !checkbox.checked 来切换。
读写标签代码上的属性:getAttribute 与 setAttribute
为什么需要?开发者可能写自定义属性,例如 loadPic="100.jpg",它不是标准内置属性,不能用点语法可靠读取。怎么想?这时要用专门操作“标签代码上属性”的方法。怎么做?
js
console.log(imageBox.getAttribute('loadPic'));
console.log(imageBox.getAttribute('src'));
imageBox.setAttribute('src', './images/new.jpg');
imageBox.setAttribute('home-address', '北京');易错点:getAttribute 不区分内置属性和自定义属性,只看标签代码上有没有写;没写就是 null。它不会像点语法那样把 width 处理成数字,也不会把 checked 处理成布尔值。setAttribute 若属性不存在会新增到文档结构的元素上。转写稿还提到自定义属性可用来“藏数据”,淘宝等网站检查元素时能看到大量自定义属性,但具体含义只有开发者自己知道。
获取元素:先明确“单个元素”还是“集合”
为什么需要:DOM 操作的第一步是拿到元素,后面才能改样式、改内容、绑事件。怎么想:先判断方法返回的是单个元素、null,还是伪数组集合;集合要遍历或按索引取。怎么做:优先用 CSS 选择器方法,特殊元素用快捷方式。易错点:不要把所有获取结果都当成数组直接调用数组方法。
① 通过 ID 名
为什么需要:ID 在文档中通常唯一,最适合精确拿单个元素。怎么想:getElementById 只按 ID 找,参数不要加 #。怎么做:
js
document.getElementById('ID名')1. 返回符合条件的元素对象
2. 如果获取不到元素,返回 null易错点:找不到时是 null,不是空集合;转写稿还提醒,浏览器会自动创建与 ID 同名的变量,但不建议依赖,可读性差且不规范。
② 通过标签名
为什么需要:同一类标签可能有很多,需要批量获取。怎么想:可从 document 找全文档,也可从某个元素的后代中找。怎么做:
js
// 从文档中获取所有指定标签名的元素
document.getElementsByTagName('标签名');

// 从某个元素的后代中获取所有指定标签名的元素
元素.getElementsByTagName('标签名');1. 返回的是一个 HTMLCollection 对象,是一个伪数组,里面的成员是元素对象
2. 如果没有符合条件的元素,同样返回 HTMLCollection 对象,是个空集合易错点:没有匹配时仍返回空集合,不是 null;集合是伪数组,不能直接 forEach 前要先确认方法兼容性,通常可用索引或遍历。
③ 通过类名(了解,IE8+ 支持)
为什么需要:类名适合按样式分组批量选元素。怎么想:和标签名类似,也返回集合。怎么做:
js
// 从文档中获取所有指定类名的元素
document.getElementsByClassName('标签名');

// 从某个元素的后代中获取所有指定类名的元素
元素.getElementsByClassName('标签名');1. 返回的是一个 HTMLCollection 对象,是一个伪数组,里面的成员是元素对象
2. 如果没有符合条件的元素,同样返回 HTMLCollection 对象,是个空集合易错点:参数写类名本身,不要带点;笔记代码中参数文字写成“标签名”,实际应理解为类名。
④ 通过 name 属性值(了解)
为什么需要:表单元素常用 name 分组,需要按 name 批量取。怎么想:只有 document 才有这个方法。怎么做:
js
// 只要 document 才有 getElementsByName 方法
document.getElementsByName('name属性值');1. 返回的是一个 NodeList 对象,是一个伪数组,里面的成员是元素对象
2. 如果没有符合条件的元素,同样返回 NodeList 对象,是个空集合易错点:返回 NodeList,不是 HTMLCollection;没有匹配仍是空集合。
⑤ 使用 CSS 选择器获取元素(推荐)
为什么需要:CSS 选择器“指哪打哪”,ID、类、标签、后代、伪类都能组合。怎么想:querySelector 只要第一个,querySelectorAll 要全部。怎么做:
js
// 从整个文档中获取
document.querySelector('CSS选择器')
document.querySelectorAll('CSS选择器')

// 从指定元素的后代中获取
元素.querySelector('CSS选择器')
元素.querySelectorAll('CSS选择器')1. querySelector() 返回符合选择器条件的第一个元素,没有符合条件的元素返回 null
2. querySelectorAll() 返回所有符合选择器条件的元素组成的集合,是 NodeList 对象,是伪数组。转写稿调试过程:写 document.querySelector('.item') 时,即使页面有多个 item,也只拿第一个;写 document.querySelector('.wrapper .item') 可限定后代。若选择器写成 .wrapper .item.active 而页面没有匹配,querySelector 返回 null;querySelectorAll 则返回空集合。易错点:querySelectorAll 永远返回集合,哪怕只有一个或零个;集合需遍历或索引取值。
⑥ 快捷方式获取元素
为什么需要:html、head、body 在文档中特殊且常用,不必每次写选择器。怎么想:浏览器提供现成属性。怎么做:
js
document.body				获取到body元素
document.head				获取到head元素
document.documentElement	获取到html元素(根元素)
document.all 获取本文档中所有的元素组成的集合使用 document.all 判断是否是 IE 浏览器:
js
if (document.all) {
     // IE10以及以下的浏览器
     document.write('您使用的是IE浏览器!');
 } else {
     // IE11、EDGE、Chrome、Firefox、Safari 等等
     document.write('您使用的不是IE浏览器!');
}易错点:现代浏览器里 document.all 有集合值,但转布尔会得到 false,这是特殊行为;不要用常规“有值就是 true”推理。document.all 得到的是全部元素集合,也是伪数组。
为什么需要“根据元素关系获取元素”
前面学的是从文档中直接找元素,比如按 id、标签名或选择器获取。但实际开发里经常是:已经拿到某个元素,并对它操作完了,接着还要操作它的子元素、父元素或兄弟元素。这时如果重新从 document 上再查一遍,不但麻烦,还容易把范围搞大。更自然的思路是:先拿到一个基准元素,再顺着文档结构找它周围的元素。这就是“根据元素关系获取元素”。
本节要掌握的属性如下,先原样保留笔记代码:
js
children				获取所有的子元素,是一个 HTMLCollection 类型的对象
firstElementChild		获取第一个子元素
lastElementChild		获取最后一个子元素

parentElement			获取父元素

previousElementSibling	获取紧邻的前面的一个兄弟元素
nextElementSibling 获取紧邻的后面的一个兄弟元素这里的“元素关系”指的是元素树:父元素、子元素、兄弟元素。它和“节点树”不是一回事。节点树里除了元素节点,还会有文本节点、注释节点等;元素树只关心元素。转写里特别强调:以前节点方法兼容性好,但会拿到换行、空格等文本节点,处理起来很烦;现在直接学元素关系更合理。
children:获取所有子元素
为什么需要:想批量操作某个容器下面的所有子元素时,需要一个集合。
怎么想:不要用 childNodes 去拿“所有子节点”,因为换行、空格也会被算成文本节点;要拿“所有子元素”,就用 children。
怎么做:父元素.children 返回 HTMLCollection 类型对象,是伪数组,可以遍历,也可以用索引取某一个。
易错点:children 只包含元素,不包含文本节点。转写里的调试很典型:一个容器里写了 6 个 <p>,直接看 childNodes 却是 13 个,因为 <p> 之间的换行被当成了文本节点,第一个成员还是文本节点,第二个才是 <p>;换成 children 后就是 6 个,而且每个成员都是元素。另一个易错点是:想拿第二个子元素,没有专门的 secondElementChild,要用 children[1]。
firstElementChild 与 lastElementChild
为什么需要:经常只想操作第一个或最后一个子元素,比如给第一项加样式、给最后一项去掉边框。
怎么想:既然只要一个元素,就不要先拿集合再绕。
怎么做:父元素.firstElementChild 获取第一个子元素;父元素.lastElementChild 获取最后一个子元素。它们返回的是元素本身,不是集合。
易错点:不要和 firstChild、lastChild 混用。后者是节点方法,可能拿到换行文本。转写中第一个子节点是换行文本,拿它没有意义;所以宁可属性名长一点,也要用 firstElementChild。另外,如果容器没有子元素,这类属性会得到 null,后续操作前要判断。
parentElement:获取父元素
为什么需要:拿到子元素后,有时要回头操作它的父容器,比如从某个按钮找到所在卡片。
怎么想:从当前元素往上找一层。
怎么做:元素.parentElement 获取父元素。转写里对 booksELE 取 parentElement,得到的是 body;再对结果继续 .parentElement,得到的是 html。
易错点:parentElement 只往上找一层,不是找所有祖先。到 html 再往上就是 null。不要和 parentNode 混用;本节按元素树记 parentElement 即可。
previousElementSibling 与 nextElementSibling
为什么需要:操作完当前元素,常常要操作它紧挨着的前一个或后一个兄弟元素。
怎么想:只找“紧邻”的兄弟元素,不是找所有兄弟。
怎么做:元素.previousElementSibling 获取前面紧邻的兄弟元素;元素.nextElementSibling 获取后面紧邻的兄弟元素。转写里验证:booksELE 前面的兄弟是 h1,后面的兄弟是 a。
易错点:这两个属性返回单个元素,不是集合;找不到时返回 null。不要用 previousSibling、nextSibling 代替,因为它们可能拿到换行文本节点。还要注意“紧邻”二字:中间隔着别的元素,拿到的就不是你想要的那个。
小结:先拿基准,再按元素树走
这一节的用法可以概括为:先获取一个元素作为基准,然后往下用 children、firstElementChild、lastElementChild,往上用 parentElement,左右用 previousElementSibling、nextElementSibling。核心易错点只有一个:始终区分“节点”和“元素”。节点方法会把换行、空格算进去,元素方法只认标签元素。把这一点想清楚,文档结构获取元素就不会乱。
一、用 CSS 选择器获取元素
为什么需要:getElementById、getElementsByTagName 能选元素,但表达力有限。CSS 选择器“指哪打哪”,JS 也应能直接复用。
怎么想:把 CSS 选择器字符串交给 querySelector / querySelectorAll,让浏览器按选择器规则找元素。
怎么做:
js
const bookEle = document.querySelector('#books'); // 第一个匹配元素
const firstItem = document.querySelector('.item'); // 多个.item只要第一个
const items = document.querySelectorAll('.item');  // 所有.item,NodeList
const oddP = document.querySelector('.wrapper p:nth-child(odd)');也可以从某个元素的后代中找:
js
const p = bookEle.querySelector('p');    // books后代中第一个p
const ps = bookEle.querySelectorAll('p'); // books后代中所有p易错点:querySelector 只返回第一个匹配元素,没有匹配返回 null;querySelectorAll 永远返回集合,没有匹配就是空集合。参数是 CSS 选择器字符串,# 表示 id,. 表示类名。
二、快捷获取与特殊现象
为什么需要:html、body 太常用,每次写选择器麻烦;document.all 可一次拿到所有元素。
怎么做:
js
document.documentElement.style.border = '1px solid red';
document.body.style.border = '1px solid green';
console.log(document.all.length); // 文档中所有元素组成的集合document.all 还可作为历史技巧判断旧 IE:if (document.all) { ... }。它不符合常规布尔转换,只作了解,新项目不要依赖。
另外,JS 会为有 id 的元素自动创建同名变量,例如 id 为 books 时可直接用 books。易错点:这不标准、可读性差,变量名写错时容易“看起来没获取却还能用”,开发中仍应老老实实 querySelector 或 getElementById。
三、按文档结构获取元素
为什么需要:已拿到父元素后,常要继续操作子元素、兄弟元素,没必要重新从文档查找。
怎么想:区分“节点树”和“元素树”。childNodes 包含换行文本、注释等;children 只包含元素。开发中优先用元素树。
怎么做:
js
const books = document.querySelector('#books');

console.log(books.childNodes.length); // 含换行文本,可能为13
console.log(books.children.length);   // 只算子元素,6
console.log(books.firstElementChild);
console.log(books.lastElementChild);
console.log(books.parentElement);
console.log(books.previousElementSibling);
console.log(books.nextElementSibling);

books.children[2].style.textDecoration = 'underline wavy red';易错点:firstChild 可能拿到换行文本,firstElementChild 才是第一个子元素;children 是 HTMLCollection,可用索引和遍历,但不是数组。
四、读写内置属性
为什么需要:用 JS 换图、改宽高、控制复选框选中状态。
怎么想:HTML 标准规定的属性会映射成元素对象的属性。图片的 src、alt、width、height,表单的 checked 等,都可用“点语法”读写。
怎么做:
js
const imageBox = document.querySelector('img');

console.log(imageBox.src);    // 会被解析成绝对路径,中文可能编码
console.log(imageBox.alt);
console.log(imageBox.width);  // 数字
console.log(imageBox.height); // 未写也可能读到计算值
console.log(imageBox.id);     // 未写是空字符串

imageBox.src = './images/poker.jpg';
imageBox.width += 50;

const check = document.querySelector('#checkBook');
console.log(check.checked); // true/false
check.checked = !check.checked;易错点:src 读取时可能被处理成绝对路径;width、height 是数字;标准属性即使没写在标签上,对象里也可能存在,只是值为空字符串或默认值;checked 这类布尔属性读出来是布尔值,不是字符串。
五、getAttribute 与 setAttribute
为什么需要:自定义属性(如 data-pic)没有映射成对象属性,不能用 imageBox.dataPic 读取;同时也要精确读写“标签代码上写过的属性”。
怎么想:getAttribute / setAttribute 不区分内置和自定义,只看标签上有没有写。
怎么做:
js
console.log(imageBox.getAttribute('data-pic')); // 自定义属性
imageBox.setAttribute('data-pic', '200.jpg');
imageBox.setAttribute('data-address', '...');   // 不存在会添加

console.log(imageBox.getAttribute('src'));    // 原样字符串,不解析
console.log(imageBox.getAttribute('height')); // 标签没写则 null易错点:getAttribute 返回字符串,不做 width 数字转换,也不把 checked 转布尔;手动勾选复选框,不会让 getAttribute('checked') 变成 true。setAttribute 改的是文档结构中的元素,不是磁盘上的源码文件。自定义属性常用来藏数据,但不要滥用。
课堂画面
代码示例
1. CSS 选择器获取元素 + 快捷方式 + 文档结构
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>DOM 获取元素与文档结构</title>
  <style>
    .wrapper {
      margin: 20px;
      width: 600px;
      background: #ccc;
    }
    .wrapper p {
      margin: 20px;
      background: #099;
      color: #fff;
    }
  </style>
</head>
<body>
  <h1>文档结构</h1>

  <div id="books" class="wrapper">
    <p>1</p>
    <p>2</p>
    <p>3</p>
    <p>4</p>
    <p>5</p>
    <p>6</p>
  </div>

  <a href="#">链接</a>

  <script>
    // 通过 CSS 选择器获取元素
    const booksEle = document.querySelector('#books');
    console.log(booksEle);

    // querySelector 只获取符合条件的第一个元素
    const firstP = document.querySelector('.wrapper p');
    console.log(firstP);

    // querySelectorAll 获取所有符合条件的元素,返回 NodeList 伪数组
    const allP = document.querySelectorAll('.wrapper p');
    console.log(allP, allP.length);

    // 快捷方式获取元素
    console.log(document.body);
    console.log(document.head);
    console.log(document.documentElement);

    // 文档结构:根据元素关系获取元素
    console.log(booksEle.children);            // HTMLCollection,6 个 p
    console.log(booksEle.firstElementChild);   // 第一个子元素 p
    console.log(booksEle.lastElementChild);    // 最后一个子元素 p

    // 第二个子元素
    console.log(booksEle.children[1]);

    // 给第三个子元素设置下划线
    booksEle.children[2].style.textDecoration = 'underline wavy red';

    // 父元素、兄弟元素
    console.log(booksEle.parentElement);          // body
    console.log(booksEle.previousElementSibling); // h1
    console.log(booksEle.nextElementSibling);     // a
  </script>
</body>
</html>关键行与易错点:
document.querySelector('CSS选择器')返回符合条件的第一个元素;没有找到返回null。document.querySelectorAll('CSS选择器')永远返回集合,即NodeList伪数组;没有找到返回空集合。querySelector参数写 CSS 选择器,例如#books、.wrapper p;getElementById参数不写#。children获取所有子元素,返回HTMLCollection伪数组,不包含换行、空格等文本节点。firstElementChild、lastElementChild、parentElement、previousElementSibling、nextElementSibling获取的都是元素本身,不是集合。- 不要误用
childNodes获取子元素,它会把换行文本也当成节点。
2. 读写内置属性
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>读写内置属性</title>
  <style>
    img {
      display: block;
      margin: 10px 0;
    }
  </style>
</head>
<body>
  <img
    id="imageBox"
    src="images/1.jpg"
    alt="小乐正在吃蛋糕"
    title="小乐正在吃蛋糕"
    width="300"
  >

  <input type="checkbox" id="checkBook" checked> 复选框

  <button id="btn01">读取属性值</button>
  <button id="btn02">换图</button>
  <button id="btn03">放大</button>
  <button id="btn04">缩小</button>
  <button id="btn05">读取/切换 checked</button>

  <script>
    const imageBox = document.querySelector('#imageBox');
    const checkBook = document.querySelector('#checkBook');

    document.querySelector('#btn01').onclick = function () {
      console.log('src:', imageBox.src);
      console.log('alt:', imageBox.alt);
      console.log('title:', imageBox.title);
      console.log('width:', imageBox.width);   // 数字
      console.log('height:', imageBox.height); // 数字,未写也能读到
      console.log('id:', imageBox.id);         // 没写就是空字符串
    };

    document.querySelector('#btn02').onclick = function () {
      imageBox.src = 'images/2.jpg';
    };

    document.querySelector('#btn03').onclick = function () {
      imageBox.width += 50;
    };

    document.querySelector('#btn04').onclick = function () {
      imageBox.width -= 50;
    };

    document.querySelector('#btn05').onclick = function () {
      console.log('切换前 checked:', checkBook.checked);
      checkBook.checked = !checkBook.checked;
    };
  </script>
</body>
</html>关键行与易错点:
- HTML 标签上的内置属性会映射成元素对象的属性,可以直接用
元素.属性名读取和设置。 imageBox.src读取时会解析成绝对路径,相对路径和中文可能被编码处理。imageBox.width、imageBox.height读取到的是数字;没有写height也能读到计算后的高度。- 没有写
id时,imageBox.id得到的是空字符串,不是undefined。 checked是布尔属性,读取到的是布尔值;用户勾选或取消会改变它。checkBook.checked = !checkBook.checked可以切换选中状态。- 内置属性可以直接点语法读写,但自定义属性不能这样读写。
- 示例中的
images/1.jpg、images/2.jpg换成自己的图片路径即可运行。
3. getAttribute 与 setAttribute 读写标签代码上的属性
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>getAttribute 与 setAttribute</title>
</head>
<body>
  <img
    id="imageBox"
    src="images/1.jpg"
    alt="小乐"
    loadPic="100.jpg"
    width="300"
  >

  <input type="checkbox" id="checkBook" checked>

  <button id="btn01">读取属性值</button>
  <button id="btn02">设置属性值</button>
  <button id="btn03">读取 checked 属性</button>

  <script>
    const imageBox = document.querySelector('#imageBox');
    const checkBook = document.querySelector('#checkBook');

    document.querySelector('#btn01').onclick = function () {
      console.log(imageBox.getAttribute('loadPic')); // "100.jpg"
      console.log(imageBox.getAttribute('src'));     // 原样字符串
      console.log(imageBox.getAttribute('width'));   // "300" 字符串
      console.log(imageBox.getAttribute('height'));  // null,代码上没写
    };

    document.querySelector('#btn02').onclick = function () {
      imageBox.setAttribute('src', 'images/2.jpg');
      imageBox.setAttribute('home-address', '北京');
    };

    document.querySelector('#btn03').onclick = function () {
      console.log(checkBook.getAttribute('checked')); // "" 或 null
    };
  </script>
</body>
</html>关键行与易错点:
getAttribute('属性名')读取的是标签代码上写过的属性,不区分内置属性和自定义属性。- 标签代码上没有写的属性,
getAttribute返回null,例如getAttribute('height')。 getAttribute('src')返回原样字符串,不会像imageBox.src那样解析成绝对路径。getAttribute('width')返回字符串"300",不是数字。setAttribute('属性名', '值')有两个参数;属性存在就修改,不存在就添加。setAttribute修改的是文档结构中的元素,不是直接改源代码。- 判断复选框是否选中应使用
checkBook.checked,不要用getAttribute('checked')。 - 自定义属性常用于在标签上藏数据,例如
loadPic="100.jpg";它本身没有标准含义,由开发者自己约定。
常见错误
1. 集合 API 返回空集合,却被当成“没找到”来判空
- 现象:
const list = document.getElementsByTagName('li'); if (list) { list[0].style.color = 'red' }在没有 li 时抛出Cannot read properties of undefined。 - 原因:
getElementsByTagName/getElementsByClassName/querySelectorAll找不到时返回空集合(不是null),空集合本身是 truthy,if (list)永远成立,但list[0]是undefined。 - 修法:判长度而不是判对象——
if (list.length) {...};只有getElementById和querySelector才需要判null。
2. 把 HTMLCollection / NodeList 当数组用
- 现象:
document.querySelectorAll('.item').map(el => el.textContent)报map is not a function;list.push(...)报错。 - 原因:两者都是伪数组,只有
length和数字索引,原型上没有任何 Array 方法。 - 修法:
Array.from(list)或[...list]转成真数组后再用map/filter/forEach;遍历时用for循环或forEach(NodeList 有forEach,HTMLCollection 没有)。
3. 缓存了集合引用,循环中增删元素后结果“越遍历越多”
- 现象:给所有
.item加元素时,for循环里追加了新的.item,循环次数不断增加甚至死循环。 - 原因:
getElementsByClassName/children返回的是动态集合,DOM 一变它立刻跟着变;而querySelectorAll返回的是静态快照。 - 修法:涉及增删的遍历,统一用
querySelectorAll拿快照;或者先Array.from固化再操作。
4. 用 getAttribute 判断布尔属性的状态
- 现象:
if (checkbox.getAttribute('checked'))明明勾选了却进不去分支;反过来if (el.getAttribute('disabled'))在写了disabled时得到"",被判为 false。 - 原因:
getAttribute只读标签代码上写死的字符串,无值属性返回"",它跟元素当前状态无关;用户交互改变的勾选状态不会反映到 attribute 上。 - 修法:状态一律用点语法
el.checked/el.disabled/el.selected读写布尔值;getAttribute只用于读取代码里写死的初始值。
5. 想读“有没有这个属性”,却读了内置属性拿到默认值
- 现象:
if (img.width)想判断标签上是否写了 width,结果没写也返回真实渲染宽度;if (img.src)永远为真。 - 原因:内置属性由标准预先挂到元素对象上,没写也有值(
''、数字、解析后的绝对 URL)。 - 修法:判断“代码里写没写”用
el.hasAttribute('width')或el.getAttribute('width') !== null;el.src会被解析成绝对路径,要原样字符串就用getAttribute('src')。
6. 脚本先于元素执行,拿到 null
- 现象:
<script>写在<head>里,document.querySelector('#box')返回null,后续操作报错。 - 原因:DOM 还没解析到该元素,查询时文档里确实不存在。
- 修法:脚本放到
</body>前;或包在document.addEventListener('DOMContentLoaded', ...)中;或用defer。
7. 用关系属性时混入节点版 API
- 现象:
el.firstChild拿到的是换行文本,el.previousSibling拿到的也是空白文本,样式加不上。 - 原因:
childNodes / firstChild / previousSibling面向所有节点,HTML 里的换行和缩进都是文本节点。 - 修法:只用 Element 版——
children / firstElementChild / lastElementChild / parentElement / previousElementSibling / nextElementSibling。
练习
1. 高亮全部并标记序号 页面上有 6 个 .item。用一次查询拿到全部元素,为每个元素写入自定义属性 data-index(从 1 开始),并在元素文本后追加 #序号。要求:代码中不得出现 getElementsByClassName。
考点:
querySelectorAll+ 伪数组遍历 +setAttribute。
2. 点击卡片切换选中态 一个 .list 下有若干 .card,点击某张卡片时:该卡片加 active 类,其余卡片移除 active。只允许在点击事件里使用 parentElement 和 children 定位,不允许用 document.querySelectorAll 重新查询。
考点:元素关系定位 +
classList批量清理。
3. 图片查看器 一个 <img id="pic"> 和三个按钮。点击按钮 1 读取并打印图片的 src(要求打印出与标签代码里完全一致的字符串,而不是绝对路径);点击按钮 2 换成另一张图;点击按钮 3 读取标签上 alt 的原始值,若标签上压根没写 alt,打印 未设置。
考点:
getAttribute与内置属性el.src的差异、null判定。
4. 手写 getSiblings 封装 function getSiblings(el),返回该元素的所有兄弟元素(不含自身),返回真数组。要求遍历时不能出现任何文本节点。
考点:
parentElement.children+ 过滤自身。
5. 找 bug
js
var btns = document.getElementsByClassName('btn');
if (btns) {
  for (var i = 0; i < btns.length; i++) {
    btns[i].onclick = function () {
      var box = document.getElementById('box');
      box.setAttribute('className', 'active');
      console.log(box.getAttribute('data-id'), box.checked);
    };
  }
}指出至少 4 处问题并改正。
考点:集合判空、
setAttribute的属性名、getAttribute与布尔状态的混用、属性名与自定义属性的取值方式。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 获取元素-使用CSS选择器 | 15:53 |
| 2 | 获取元素-快捷方式 | 03:43 |
| 3 | 快速区分IE的一种方式 | 05:56 |
| 4 | JS中会自动创建与ID同名的变量 | 03:10 |
| 5 | 文档结构-根据元素关系获取元素 | 16:49 |
| 6 | 属性操作-读写内置属性 | 23:12 |
| 7 | 属性操作-读写标签代码上的属性 | 11:29 |
小结
- 选型结论:日常一律用
querySelector / querySelectorAll;只在明确按 id 取单个元素时用getElementById。getElementsByClassName、getElementsByName、document.all属于“认识即可”,不进业务代码。 - 返回值只有两类,判断方式必须跟着变:单个元素 API 返回元素或 null,判
null;集合 API 返回集合(永不为 null),判length。把这两类混着判空,是新手期最高频的线上报错来源。 - 集合的“死活”决定能不能缓存:
getElementsBy*、children是动态的,querySelectorAll是静态快照。凡是循环中会改动 DOM 的场景,先转成真数组再动手。 - 关系属性只记 Element 系列六个(
children、firstElementChild、lastElementChild、parentElement、previousElementSibling、nextElementSibling),节点版 API 在 HTML 里基本只会给你添乱。 - 属性操作是两套并行体系,不要混:点语法面向“元素对象的状态”,会做类型化处理(布尔、数字、绝对 URL);
getAttribute/setAttribute面向“标签上写的字符串”,原样进出、不区分内置与自定义、不做类型转换。 - 判断属性是否存在,用
hasAttribute/getAttribute(...) !== null;判断控件当前状态,用el.checked这类点语法。这两件事在语义上完全不同。 - 自定义属性(含
data-*)是 DOM 与业务数据之间的合法通道,用于携带“页面上看不见但要用”的信息;但它是约定而非契约,取值前要能容忍缺失。 - 两条别碰的坑:靠“ID 同名全局变量”省掉获取步骤(不可读、模块化下失效),用
document.all做浏览器判断(IE11 已失效,且它被标准固化成 falsy 的兼容怪癖)。