主题
redux-toolkit与redux 核心概念(Day8 2/3)
本页对应 React + TypeScript + 医通项目,共 5 段视频,约 1 小时 1 分。
学习目标
- 能使用
NavLink的className回调,根据isActive返回自定义高亮类名,并在 CSS 中定义对应高亮样式。 - 能将路径与路由组件的映射关系抽离为路由表数组,并使用
useRoutes生成路由配置。 - 能完成一级路由页面改造:配置
NavLink导航、路由展示区域及默认重定向。 - 能通过
children配置二级路由,使用Outlet渲染子路由,并正确区分完整路径与简写路径的写法规则。 - 能使用
useNavigate实现编程式导航,并通过第二个参数replace或数字参数控制历史记录的前进、后退与替换行为。 - 能说明 Redux 的核心概念(store、action、reducer),并使用
redux-toolkit创建 slice/store,在组件中完成状态读取与更新。
知识点
本节资料边界:转写稿与笔记不是同一主题
本节笔记只有两条核心信息:redux-toolkit 是官方提供的 Redux 工具包,作用是对数据状态进行集中式管理;react-redux 是在 React 中更方便使用 Redux 的绑定层。 但给定转写稿实际讲的是 React Router:NavLink 自定义高亮、路由表与 useRoutes、Outlet 二级路由、useNavigate 编程式导航等。它们属于路由层知识,不能硬说成 redux-toolkit 的推导过程,否则就是编造。因此本文只围绕笔记中的 Redux 两条主线扩写;转写稿仅用于说明“资料边界”和纠正同音字,不把路由 API 混入 Redux 教程。本节笔记未附图片和代码,故不插入图片与代码块,避免虚构。
转写稿中需纠正的同音字/误写包括:nameve L、name link 应为 NavLink;bo strap 应为 Bootstrap;use.Roots、use roose 应为 useRoutes;out light 应为 Outlet;nave user naG、use navigate 应为 useNavigate;exactive、is active 应为 isActive;pass 应为 path;eleement 应为 element;重定项、重命项 应为 重定向;local store reach 应为 localStorage;GS 应为 JS。这些纠错只用于说明转写稿主题,不作为 Redux 知识点。
知识点一:redux-toolkit 是官方 Redux 工具包
为什么需要: 当多个组件需要共享同一份数据,且更新逻辑分散时,只靠组件局部状态容易产生“数据源不一致、更新入口太多、排查困难”的问题。Redux 的思路是把这类状态集中管理,而 redux-toolkit 是官方提供的工具包,用来降低原生 Redux 的使用成本。笔记明确它的作用是“对数据状态进行集中式管理”,所以理解重点不是“多了一个新库”,而是“官方给出的 Redux 使用方案”。
怎么想: 先判断状态是否真的需要集中管理。跨页面、跨层级、多个组件共同读写的数据,才适合放进集中式状态;单个组件内部的临时状态,不应为了“统一”而全局化。redux-toolkit 仍然是 Redux 体系,不是 React 专属,也不等于路由工具。转写稿里的 NavLink、useRoutes、Outlet、useNavigate 解决的是“页面跳转与路由展示”,不是“业务数据集中管理”,两者层级不同。
怎么做: 在概念上把它作为 Redux 的官方工具包接入项目:围绕集中式 store 组织状态,把不同业务状态拆成清晰的状态切片,让组件通过统一入口读取和更新。由于本节笔记没有给出具体 API 与代码,本文不虚构 configureStore、createSlice 等代码细节;实际编码时应以官方文档和课程后续代码为准。
易错点: 一是把 redux-toolkit 当成 React 路由或组件库;二是把所有状态都塞进全局,导致简单问题复杂化;三是只记住“工具包”三个字,却忽略它仍然要求单向数据流和清晰的状态边界;四是把转写稿中的 useNavigate 当成 Redux 的跳转方法,这是路由导航,不是状态管理。
知识点二:react-redux 是 React 与 Redux 的绑定层
为什么需要: Redux 本身不依赖 React。React 组件要想方便地接入集中式 store、读取状态、触发更新,就需要一个绑定层。笔记说“react-redux:在 React 中更方便的使用 redux”,关键词是“更方便”,它不是替代 Redux,而是连接 React 与 Redux 的桥梁。
怎么想: 把职责分开:redux-toolkit 负责 Redux 侧的状态组织与工具支持;react-redux 负责让 React 组件树接入 store,并在组件中消费状态、派发更新。这样想可以避免“到底学的是 Redux 还是 React”的混乱。
怎么做: 概念上分三步理解:先有集中式 store;再让 React 组件树能够访问这个 store;最后组件按需读取状态,并通过统一入口触发更新。具体 Provider、selector、dispatch 的写法本节笔记未展开,不能凭空补成“本节代码”。实际项目中应保持“状态归属清晰、更新入口集中、组件只做必要订阅”。
易错点: 一是以为装了 react-redux 就等于有了 Redux 状态;二是把 react-redux 当成路由库;三是组件里到处直接改状态,破坏集中管理;四是订阅范围过大导致不必要的重渲染。转写稿中 useNavigate 的 replace 参数讲的是“替换当前历史记录”,不是 Redux 的状态替换,不能混淆。
知识点三:集中式管理的判断与调试思路
为什么需要: 集中式管理不是为了“看起来高级”,而是为了解决共享状态的一致性和可追踪性。若没有边界,集中式 store 会变成垃圾桶。
怎么想: 先列状态清单:哪些数据跨组件共享?哪些只是表单临时值?哪些由路由决定?路由状态应交给路由层,业务共享状态才考虑 Redux。转写稿的调试过程——如 useRoutes 路径报错、Outlet 展示二级路由、useNavigate 的 replace 影响历史记录——说明排查时要先定位“是路由配置层、组件展示层还是导航行为层”。这个“先分层定位”的思路可以借鉴,但不能把路由调试结论写成 Redux 结论。
怎么做: 按“状态归属 → 更新入口 → 消费组件 → 排查层级”的顺序设计。出现问题时先确认数据是否真的进了集中式 store,再确认组件是否从正确入口读取,最后确认更新是否走了统一流程。
易错点: 重复存储同一份数据;把临时 UI 状态全局化;把路由参数和全局业务状态混在一起;调试时只看组件,不检查状态入口。本节笔记未附图片与代码,因此正文不插入图片、不编造代码块;后续应以课程实际代码为准。
本节说明:转写稿与 Redux 笔记不匹配
先说明一个关键问题:本节笔记标题是“18-1. redux 核心概念”,核心内容是 store、slice、reducer、action、actionCreator、dispatch 六个概念;但提供的转写稿实际讲的是 React Router 相关内容,包括 NavLink 自定义高亮、路由表、useRoutes、Outlet 二级路由、useNavigate 编程式导航等。转写稿中还有大量同音字/误识别,如“nameve L”应为 NavLink,“useRoots”应为 useRoutes,“out light”应为 Outlet,“nave user naG”应为 useNavigate,“exactive”应为 isActive,“处/Foss”应为 true/false,“bo strap”应为 Bootstrap。它们属于路由章节,不能硬套成 Redux 的推导和调试过程。为避免编造,本节只按笔记中已有的 Redux 概念和类比展开;笔记没有给出代码片段,因此不虚构 API 代码。
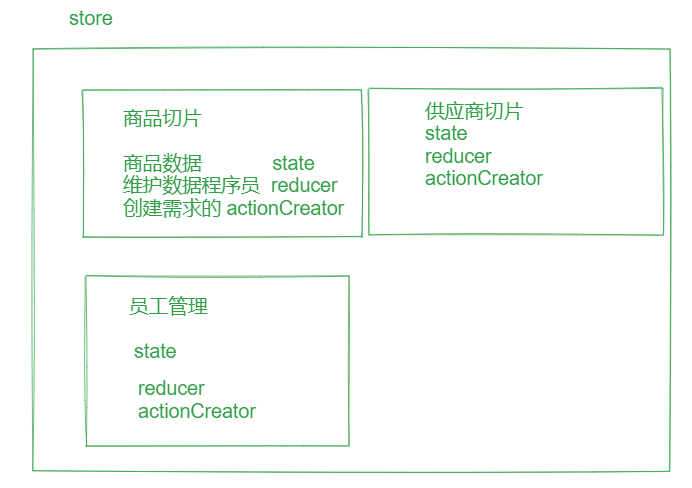
整体类比:六个概念先对上号
笔记给出一组项目类比:store 是数据仓库,对应项目经理;slice 是数据切片,对应子项目;reducer 是“减速器”,对应程序员;action 是动作行为,对应需求文档;actionCreator 是 action 的创造者,对应产品经理;dispatch 是分发,对应指派任务。
为什么需要这组类比?因为 Redux 概念多、名字抽象,初学时容易把“谁产生变化、谁执行变化、谁保存结果”混在一起。怎么想?把一次状态更新看成一个项目流转:产品经理写需求文档,项目经理指派任务,程序员按文档改代码,子项目是项目的一部分,最终结果进入数据仓库。怎么做?先记住“action 描述发生了什么,dispatch 负责派发,reducer 负责计算新状态,store 负责保存,slice 负责按业务拆分”。易错点是:笔记里的“减速器”不是规范术语,规范叫 reducer;不要按字面理解成“减速”,它不是降低速度,而是根据 action 计算新状态。
store:为什么需要数据仓库
为什么需要?当多个组件要共享同一份状态时,如果只靠组件间传参,层级一深就会很乱,所以需要一个集中存放状态的地方。怎么想?把 store 想成项目经理:所有任务和信息在这里汇总,别人不直接改仓库,而是按流程提交变化。怎么做?在概念上,把应用级共享状态放进 store,组件读取 store,更新时通过 dispatch 走统一入口。易错点:store 不是用来替代所有组件局部状态的;只把需要跨组件共享、需要可追踪变化的状态放进去。也不要在组件里直接修改 store 中的数据。
slice:为什么要把状态切片
为什么需要?一个应用的状态往往很大,如果全部混在一起,阅读和维护都困难。怎么想?把 slice 想成“子项目”:一个项目可以拆成多个子项目,每个子项目有自己的边界。怎么做?按业务模块划分 slice,例如用户、订单、消息各成一片;每片通常包含自己的初始状态和 reducer 逻辑。易错点:slice 不是多个 store,它仍是整体状态树的一部分;拆分要按业务域,不要按“每个组件一片”机械拆,否则边界会碎。
reducer:为什么需要纯计算
为什么需要?状态变化必须可预测、可追踪,不能谁想改就随便改。怎么想?reducer 像程序员:拿到“需求文档”action 后,根据当前状态计算出新状态。怎么做?概念上,reducer 接收旧状态和 action,返回新状态;它应保持纯计算,不直接改旧状态,不写请求、随机数等副作用。易错点:第一,规范名称是 reducer,不是“减速器”;第二,reducer 不负责发请求;第三,不要直接修改原状态对象,应返回新的状态结果。这样调试时才能看清“哪个 action 导致了哪次变化”。
action 与 actionCreator:为什么要把“发生了什么”说清楚
为什么需要?如果直接改状态,很难知道变化原因。action 用来描述“发生了什么”。怎么想?action 像需求文档:它说明要做什么,但不亲自改代码。actionCreator 像产品经理:专门创建 action。怎么做?概念上,action 是一个描述对象,至少应能表达动作类型和必要数据;actionCreator 是创建 action 的函数,让创建过程集中、复用。易错点:action 不是状态本身,也不是直接修改 store 的指令;actionCreator 不执行 reducer,它只负责产生 action。不要把“写需求”和“改代码”混成一步。
dispatch:为什么需要统一分发
为什么需要?如果每个组件都绕过流程直接改 store,状态变化就不可控。dispatch 是统一入口。怎么想?它像项目经理指派任务:把 action 这份“需求文档”派发给 store,再由 reducer 处理。怎么做?组件触发变化时,通过 dispatch 派发 action;store 收到后交给 reducer 计算新状态。易错点:dispatch 不是 reducer,它不负责计算;不要绕过 dispatch 直接改 store;也不要把异步请求本身当成 dispatch 的职责,异步逻辑应另行组织。
串起来:一次更新的推导顺序
把六个概念串成一条线:用户操作后,由 actionCreator 创建 action;组件通过 dispatch 派发 action;store 收到 action 后交给 reducer;reducer 根据旧状态和 action 返回新状态;store 保存新状态,视图再根据新状态刷新。这个顺序是本节最该记住的“推导链”。易错点是把顺序颠倒:actionCreator 不直接改 store,dispatch 不直接算状态,reducer 不创建 action。转写稿中的路由调试过程不能套到这里,否则会把 NavLink、Outlet、useNavigate 误当成 Redux 概念。
本节小结与检查清单
检查自己是否能说清:store 存什么;slice 为什么拆;reducer 为什么必须是纯计算;action 描述什么;actionCreator 创建什么;dispatch 派发什么。再用项目类比复述一遍:项目经理、子项目、程序员、需求文档、产品经理、指派任务。最后提醒:本节笔记没有代码,不要为了“补代码”虚构实现;转写稿属于路由章节,不能作为 Redux 调试记录使用。
学习边界说明
本节笔记的主题是 redux-toolkit 基本使用,明确给出的内容只有两步:安装 @reduxjs/toolkit,以及从包中导入 createSlice、configureStore。但提供的转写稿实际讲的是 React Router 相关内容,例如自定义高亮样式类名、路由表、useRoutes、Outlet 二级路由、useNavigate 编程式导航等,其中还有“bo strap(Bootstrap)”“useRoots(useRoutes)”“out light(Outlet)”“nave gate(useNavigate)”等同音转写问题。由于这些内容与本节 redux-toolkit 笔记不是同一主题,若强行混入就会编造 Redux Toolkit 的用法。因此,下面只依据本节笔记扩写安装与导入两个知识点,不把转写稿中的路由调试过程误写成 Redux Toolkit 内容。
安装依赖:为什么需要先安装
为什么需要:本节要使用 createSlice 和 configureStore,它们来自 @reduxjs/toolkit 这个包。项目如果没有安装该依赖,后续导入时就会找不到模块。所以第一步不是写切片或仓库,而是先把包安装到项目依赖中。
怎么想:安装是“准备工具”,导入是“把工具取出来用”。先确认当前终端位于项目根目录,再执行安装命令。不要在任意目录随手安装,否则包可能被装到别处,项目代码仍然无法导入。
怎么做:在项目根目录执行笔记中的命令:
bash
npm install @reduxjs/toolkit安装完成后,再进入代码文件写导入语句。本节不展开切片和仓库的具体配置,先把依赖入口跑通。
易错点:包名要写完整,是 @reduxjs/toolkit,不要漏掉 @reduxjs/,也不要随意改大小写;安装目录应是当前项目根目录;安装后如果编辑器仍提示找不到模块,先检查终端所在目录和项目依赖是否安装成功,而不是立刻改导入代码。
导入函数:为什么只导入这两个
为什么需要:笔记明确要用两个函数:createSlice 创建切片,configureStore 创建仓库。它们不是全局变量,必须先从 @reduxjs/toolkit 导入,才能在当前模块中使用。
怎么想:先看职责分工,再看导入方式。createSlice 面向“切片”的创建;configureStore 面向“仓库”的创建。本节只要求认识这两个入口,不要求展开完整配置。因此导入时使用命名导入,把两个函数从包中取出来。
怎么做:保留笔记中的导入代码:
js
import {createSlice, configureStore} from '@reduxjs/toolkit'导入后,当前模块中就拥有 createSlice 和 configureStore 两个标识符。后续写切片时用前者,写仓库时用后者。若暂时不写具体逻辑,也应先确认导入路径、函数名大小写与笔记一致。
易错点:第一,导入来源必须是 @reduxjs/toolkit,不要凭感觉改成其他路径;第二,createSlice 中的 S 是大写,configureStore 中的 S 也是大写,写成 createslice、configurestore 会报错;第三,这是命名导入,花括号不能丢;第四,不要把 configureStore 和 createSlice 的职责说反——笔记写得很清楚:前者创建仓库,后者创建切片。
本节小结与调试思路
本节的知识点很少,但它是后续使用 Redux Toolkit 的入口。调试时按顺序排查:先看终端是否在项目根目录执行了 npm install @reduxjs/toolkit;再看导入语句是否原样使用 import {createSlice, configureStore} from '@reduxjs/toolkit';最后看函数名大小写和花括号是否正确。只要安装与导入这两步成立,本节目标就完成了。转写稿中的路由表、Outlet、useNavigate 等内容不属于本节 redux-toolkit 笔记范围,本文不将其作为 Redux Toolkit 的推导依据。
课堂画面
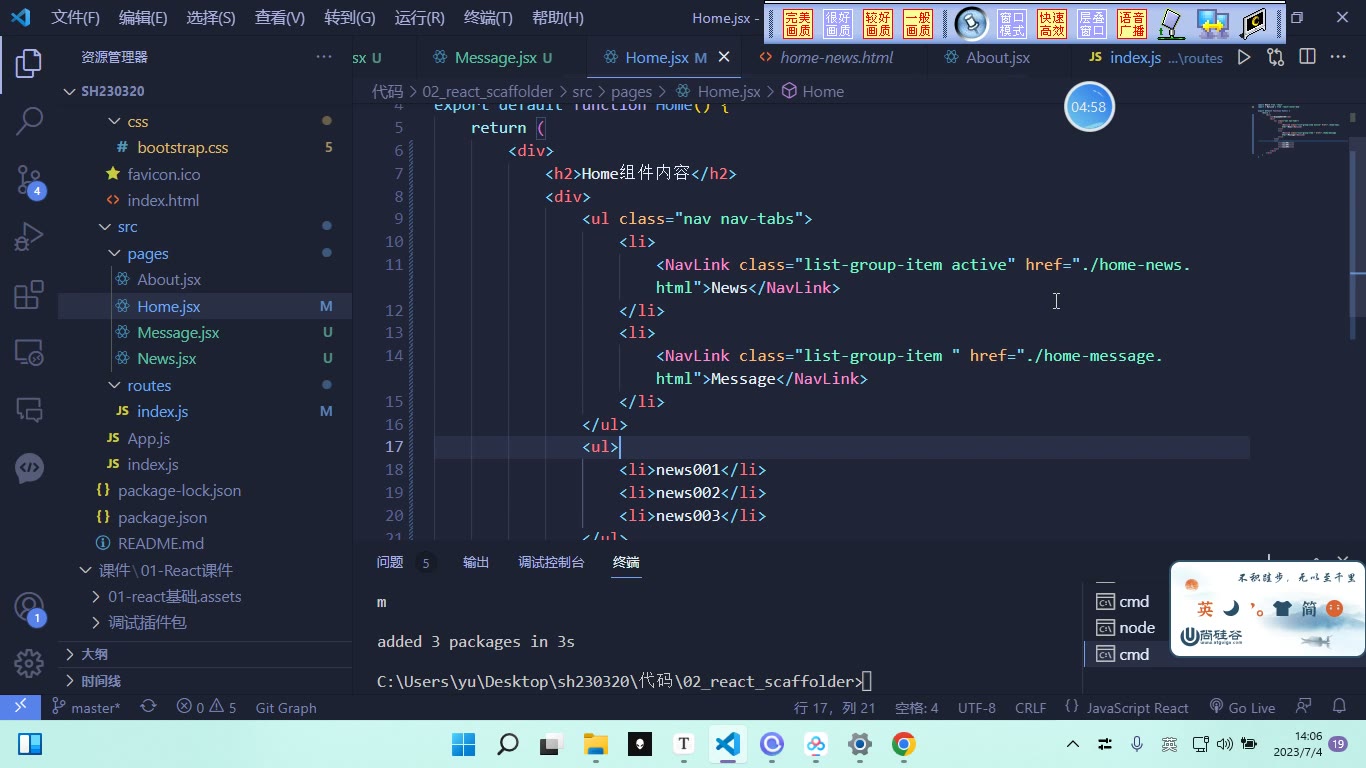
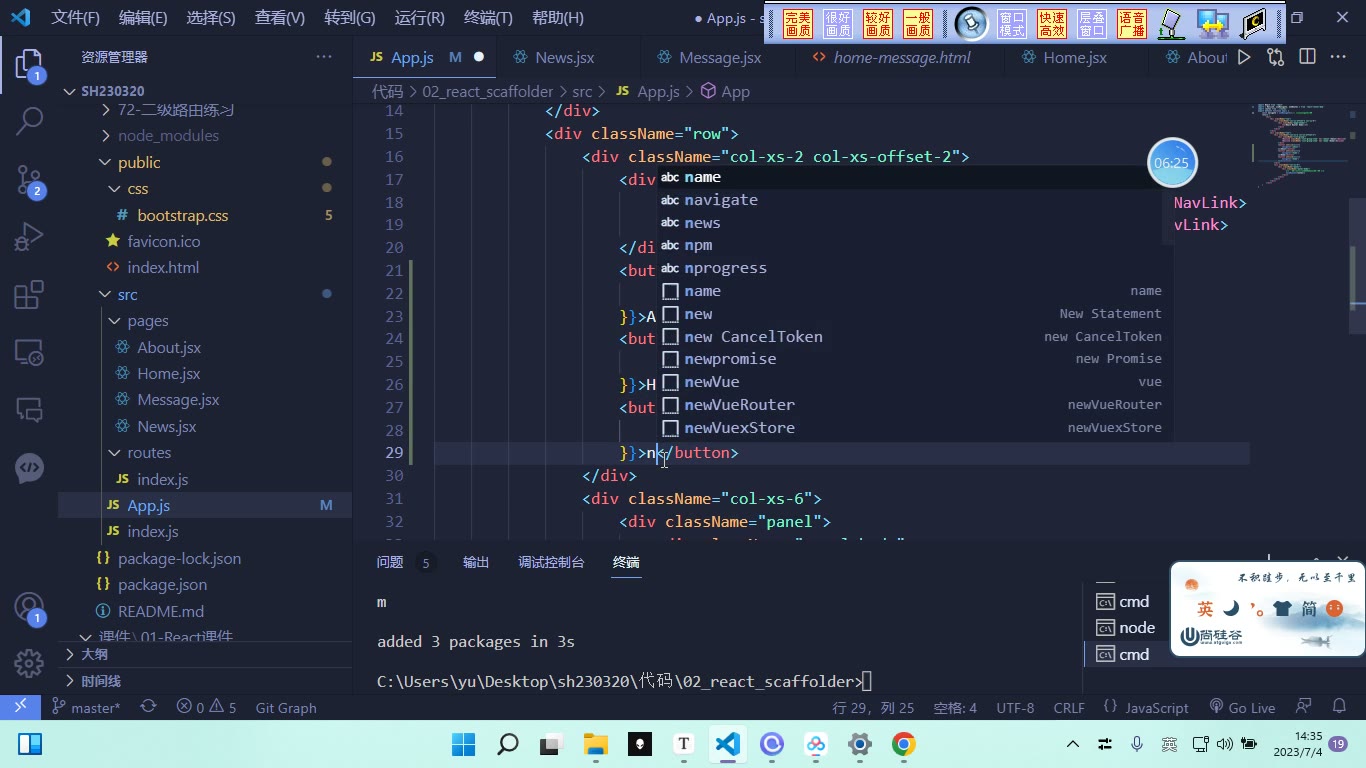
代码示例
示例 1:NavLink 自定义高亮类名(class 值为回调函数)
jsx
/* src/main.jsx */
import React from 'react'
import ReactDOM from 'react-dom/client'
import { BrowserRouter } from 'react-router-dom'
import App from './App'

ReactDOM.createRoot(document.getElementById('root')).render(
  <BrowserRouter>
    <App />
  </BrowserRouter>
)jsx
/* src/App.jsx */
import { NavLink } from 'react-router-dom'
import './App.css'

export default function App() {
  return (
    <div className="list-group">
      <NavLink className={({ isActive }) => (isActive ? 'myActive' : '')} to="/home">
        Home
      </NavLink>
      <NavLink className={({ isActive }) => (isActive ? 'myActive' : '')} to="/login">
        Login
      </NavLink>
      <NavLink className={({ isActive }) => (isActive ? 'myActive' : '')} to="/user">
        User
      </NavLink>
    </div>
  )
}css
/* src/App.css */
.myActive {
  color: #fff;
  background-color: green;
}要点解释:
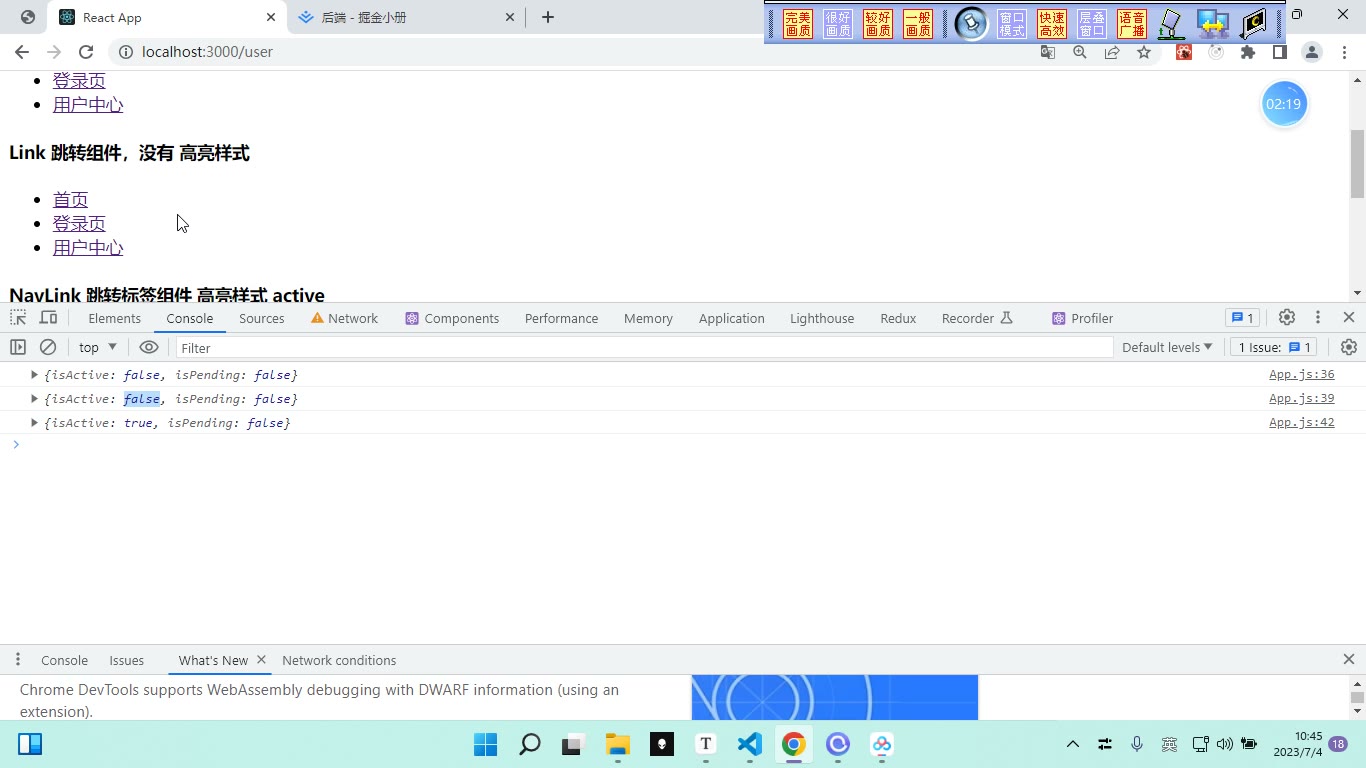
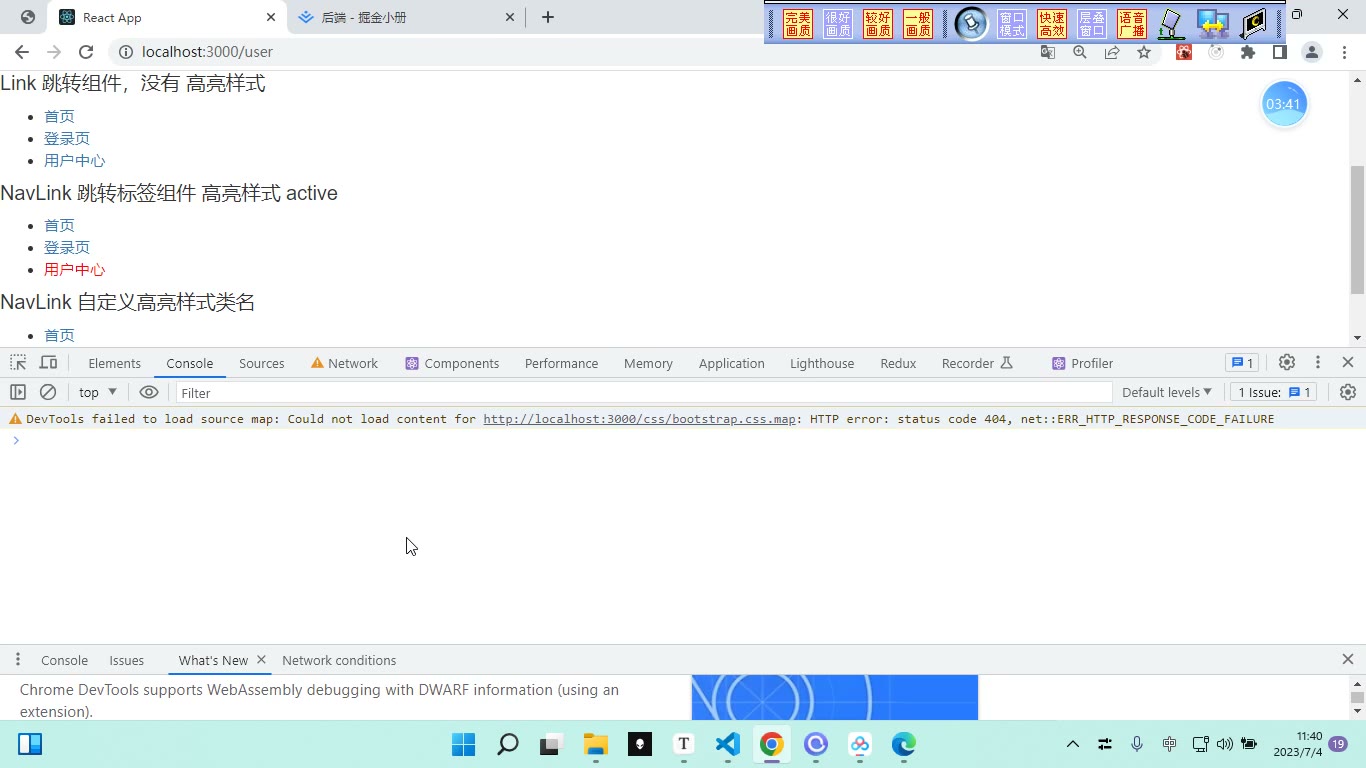
className的值可以是一个回调函数,路由解析模板时会自动调用它,回调函数的返回值会直接成为最终写进标签的类名。- 回调函数的参数是一个对象,其中包含
isActive属性(布尔值),用来表示“当前路由是否处于激活状态”;直接解构{ isActive }即可使用。 - 这样就不会使用默认的
active类名;如果项目中引入了 Bootstrap 之类的第三方库,它们也有.active,全局覆盖后会影响其他地方,所以需要自定义类名来避免冲突。 - 易错点:忘记在回调里
return(用了大括号却没有写return),或者写成className="myActive"这种固定字符串,导致三条链接同时高亮。
示例 2:路由表 + useRoutes + Outlet 二级路由
jsx
/* src/routes/index.jsx —— 路由表:一个装 path 与 element 映射关系的普通数组 */
import { Navigate } from 'react-router-dom'
import Home from '../pages/Home'
import About from '../pages/About'
import News from '../pages/News'
import Message from '../pages/Message'

const routes = [
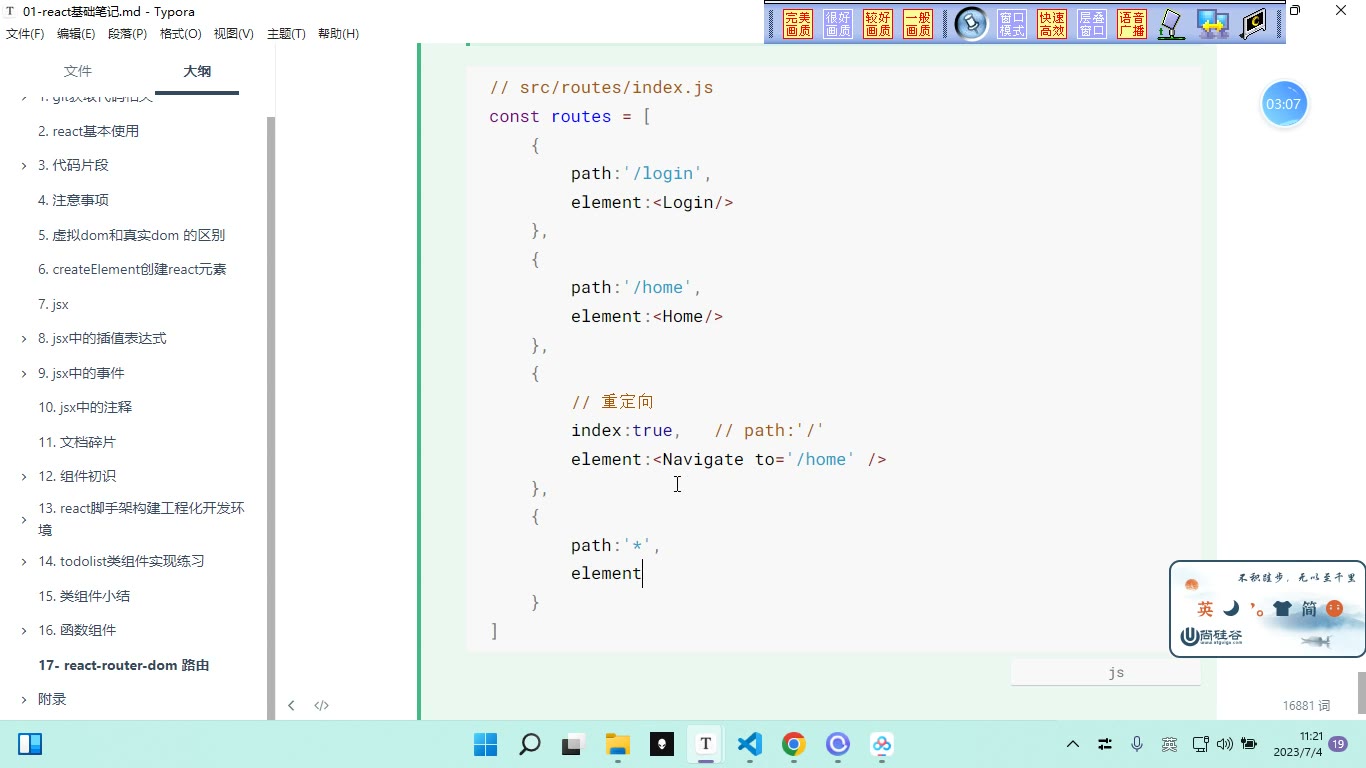
  { path: '/', element: <Navigate to="/home" /> },
  {
    path: '/home',
    element: <Home />,
    children: [
      { path: '', element: <Navigate to="/home/news" /> }, // 访问 /home 时默认展示 news
      { path: 'news', element: <News /> },                 // 简写,等价于 /home/news
      { path: 'message', element: <Message /> }            // 简写,等价于 /home/message
    ]
  },
  { path: '/about', element: <About /> },
  { path: '*', element: <div>404 页面</div> }
]

export default routesjsx
/* src/pages/Home.jsx —— 一级路由组件内部用 Outlet 展示二级路由 */
import { NavLink, Outlet } from 'react-router-dom'

export default function Home() {
  return (
    <div>
      <div className="list-group">
        <NavLink className="list-group-item" to="news">News</NavLink>
        <NavLink className="list-group-item" to="message">Message</NavLink>
      </div>
      <div className="panel-body">
        <Outlet />
      </div>
    </div>
  )
}jsx
/* src/App.jsx —— 用 useRoutes 根据路由表生成路由配置 */
import { useRoutes } from 'react-router-dom'
import routes from './routes'

export default function App() {
  const element = useRoutes(routes)
  return <div className="panel-body">{element}</div>
}要点解释:
- 路由表本质上就是普通数组,写
path和element的映射关系,比手写一堆<Route>标签简洁得多;再交给useRoutes(routes)生成真正的路由配置。 - 重定向有两种写法:
{ index: true, element: <Navigate to="..." /> }或{ path: '/', element: <Navigate to="..." /> },两者都可以。 - 二级路由用
children属性配置,children中每个子路由同样写path+element。 - 二级路由的
path使用简写时前面不能加斜杠:写成path: 'news'会被自动拼成/home/news;写成path: '/news'则被当成一级路由,会找不到。 - 易错点:路由表文件在
src/routes下,import Home from '../pages/Home'的路径要带../(视频里出现的 “cant resolve” 报错就是少了一个点);另外,所有路由组件都要在路由表文件里 import,而不要继续留在App.jsx里。
示例 3:编程式导航 useNavigate
jsx
/* src/App.jsx 中的按钮区 */
import { useNavigate } from 'react-router-dom'

export default function App() {
  const navigate = useNavigate()

  // 编程式导航可以加逻辑判断:有 token 才进用户中心
  const toUser = () => {
    const token = localStorage.getItem('token')
    if (token) {
      navigate('/user')
    } else {
      navigate('/login')
    }
  }

  return (
    <div>
      <button onClick={() => navigate('/about')}>去 About</button>
      <button onClick={() => navigate('/home')}>去 Home</button>
      {/* 跳二级路由必须写完整路径,简写 news 不生效 */}
      <button onClick={() => navigate('/home/news')}>去 News</button>
      <button onClick={toUser}>去用户中心</button>

      {/* replace: true —— 替换当前历史记录,而不是新增一条 */}
      <button onClick={() => navigate('/about', { replace: true })}>replace 跳 About</button>

      {/* 传数字相当于 history.go() */}
      <button onClick={() => navigate(-1)}>后退一步</button>
      <button onClick={() => navigate(1)}>前进一步</button>
      <button onClick={() => navigate(2)}>前进两步</button>
    </div>
  )
}要点解释:
useNavigate()返回一个navigate函数,填上路由表里配置的path就能跳转,本质是用 JS 做路由跳转,不用 A 标签。- 与
NavLink/Link最大的差别:编程式导航是 JS 代码,可以加 if 判断(如判断localStorage里有没有 token)实现有条件跳转;A 标签一点就跳,没法插入逻辑。 - 第二个参数
{ replace: true }:不生成新的历史记录,而是替换掉当前这条,点浏览器后退会跳过被替换的页面;不写时默认是false(新增一条)。 navigate(-1)/navigate(1)/navigate(2)传数字,表示在历史记录中后退/前进几步,效果类似history.go()。- 易错点:跳二级路由时
navigate('news')这种简写不生效,要写完整的/home/news;另外,跳到/home时因为配了重定向,实际会落到/home/news。
常见错误
现象:
NavLink高亮样式不生效,或所有链接都带上自定义类名。
原因:className回调参数未正确解构isActive,或返回值写成了固定字符串。
修法:回调参数中取出isActive,按布尔值返回目标类名或空字符串。现象:改用路由表后页面报模块找不到。
原因:路由表文件位置变化后,组件导入路径仍沿用原文件相对路径。
修法:以路由表文件所在目录为基准重写import路径,重点检查./、../。现象:二级路由配置后无法匹配,或跳到错误的一级路由。
原因:子路由path前多写了/,被当成一级路由处理。
修法:子路由简写时不要以/开头;需要完整路径时再写完整二级路径。现象:二级路由组件不显示,但地址栏路径已变化。
原因:父级路由组件中没有放置Outlet,或放置位置不在目标内容区。
修法:在父路由组件负责展示子路由的位置放入Outlet,并确认其未被条件渲染屏蔽。现象:使用
useNavigate跳转二级页面失败。
原因:把二级路径当成一级路径简写,例如只写子路径。
修法:编程式导航跳二级路由时写完整目标路径,或确保当前匹配上下文能正确拼接。现象:点击跳转后浏览器后退丢失上一页。
原因:navigate第二参数误用了replace: true。
修法:需要保留历史记录时不要传replace: true;只有明确要替换当前记录时才使用。
练习
- 将现有
NavLink默认高亮改为自定义类名,并在样式文件中分别验证激活态与非激活态。 - 把当前分散写的路由配置改造成路由表数组,再用
useRoutes生成配置,检查所有组件导入路径。 - 为
home增加news、message两个二级路由,并设置访问home时默认重定向到其中一个子路由。 - 在页面中增加三个按钮:跳转
about、跳转home/news、后退一步;验证普通跳转与replace跳转的历史记录差异。 - 故意把某个二级路由
path改成以/开头,观察匹配结果并修正配置。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 自定义高亮样式类名 | 06:58 |
| 2 | 路由表 | 09:24 |
| 3 | 一级路由页面练习 | 11:06 |
| 4 | Outlet二级路由配置 | 14:55 |
| 5 | 编程式导航-useNavigate | 19:17 |
小结
- 路由改造要先保证路径、组件、展示位置三者一致,再处理高亮和跳转体验。
NavLink的高亮逻辑应围绕isActive判断,不要覆盖第三方库通用类名。- 路由表适合集中维护映射关系,但文件迁移后最容易暴露相对路径问题。
- 二级路由能否显示,不只看配置,还要检查父组件中的
Outlet位置。 - 子路由路径简写和完整写法要统一策略,尤其注意开头
/的语义差异。 - 编程式导航适合带条件跳转;历史记录行为要结合
replace和前进后退参数验证。 - 页面练习应先做布局和内容区定位,再接入路由配置,排错成本更低。