主题
redux-toolkit基本使用与创建仓库-获取仓库数据-(Day8 3/3)
本页对应 React + TypeScript + 医通项目,共 5 段视频,约 43 分钟。
学习目标
- 能够配置普通路由并通过
Link的查询字符串传递 query 参数,使用useSearchParams获取指定 key 的值,并调用其设置方法更新 query 参数,通过页面展示验证结果。 - 能够通过
Link的state属性传递对象等复杂数据,使用useLocation接收并按数据结构解构取值,通过页面展示验证传递与接收结果。 - 能够使用
React.lazy与Suspense对路由组件实现按需加载,设置fallback加载提示,并封装可复用的懒加载函数,通过路由切换验证加载效果。 - 能够解释 Bootstrap 样式因相对路径在多级路由下加载失败的原因,并将引入路径改为以
/开头的绝对路径,通过刷新页面验证样式不再丢失。 - 能够区分
BrowserRouter的 HTML5 history 模式与HashRouter的 hash 模式在 URL 表现上的差异,并说明 hash 模式对相对路径资源加载的影响。
知识点
本节范围与转写稿说明
本节笔记的主题是“18-2. redux-toolkit 基本使用”,笔记只给出了两步:安装 @reduxjs/toolkit,以及从包中导入 createSlice、configureStore。需要先说明:你提供的转写稿讲的是路由 query 参数、state 参数、路由懒加载、bootstrap 相对路径、hash/history 模式等内容,和本节 Redux Toolkit 主题并不匹配。为避免编造,我不能把“query 参数怎么取”“Suspense 怎么包懒加载组件”硬套成 Redux Toolkit 的使用步骤;这些内容属于路由章节。转写稿里一些同音字也应纠正,例如“战位服”应为“占位符”、“优质”应为“use”、“哈西”应为“hash”,但它们不属于本节。下面只依据本节笔记,把“安装”和“导入”两个知识点讲清楚。本节笔记没有附带图片,因此不插入图片。
安装 @reduxjs/toolkit
为什么需要:createSlice、configureStore 都不是浏览器或 React 自带的能力,它们来自 @reduxjs/toolkit 这个 npm 包。项目里如果不先安装依赖,后续写 import ... from '@reduxjs/toolkit' 时就会找不到模块。
怎么想:基本使用顺序应当是“先有依赖,再有导入,最后才写切片和仓库”。所以第一步不是急着写代码,而是确认项目根目录和包管理器,把 toolkit 装进当前项目。
怎么做:在项目根目录执行笔记中的安装命令:
bash
npm install @reduxjs/toolkit执行后应检查 package.json 的依赖中是否出现 @reduxjs/toolkit,并确认 node_modules 已安装。
易错点:包名是带作用域的 @reduxjs/toolkit,不要写成 @redux/toolkit 或 redux-toolkit;安装命令要在项目根目录执行,不要跑到桌面或别的目录;如果团队使用 pnpm/yarn,应与项目锁文件保持一致,不要混用包管理器导致依赖状态混乱。
导入 createSlice 与 configureStore
为什么需要:安装只是把包放进项目,真正使用前还要在模块中导入函数。笔记明确说明:createSlice 是创建切片的函数,configureStore 是创建仓库的函数。先把这两个函数导入,后续才能分别组织切片和创建 store。
怎么想:这是一个“命名导入”场景,包中导出了多个成员,所以要用花括号按名称取出。导入位置通常是在需要使用它们的模块顶部;不要把 npm install 写进 JavaScript 文件。
怎么做:保留笔记中的导入语句:
js
import {createSlice, configureStore} from '@reduxjs/toolkit'其中 createSlice 对应“创建切片”,configureStore 对应“创建仓库”。本节只讲到导入,具体 slice 的字段和 store 的配置,笔记没有展开,就不在这里编造示例。
易错点:漏写花括号会变成默认导入,和 toolkit 的命名导出不匹配;函数名大小写要准确,createSlice 的 S 大写,configureStore 的 S 大写;不要把它误写成 React 包或 react-redux 包的导入;也不要把 configureStore 和旧版 Redux 的 createStore 混为一谈。
建立“安装→导入”的基本使用顺序
为什么需要:很多初学错误不是概念不会,而是顺序乱了:先写导入,发现报 Cannot find module '@reduxjs/toolkit',再回头安装;或者安装后包名写错,仍然导入失败。把顺序固定下来,排查会简单很多。
怎么想:先确认依赖存在,再确认导入语句的包名、花括号、函数名是否正确。若导入报错,先查 package.json 和 node_modules,再查拼写;若提示某个函数不是函数,优先检查命名导入和包版本。
怎么做:按“根目录安装 → 模块顶部导入 → 再写后续切片和仓库”的顺序推进。本节笔记的完整可保留代码就是上面两条:安装命令和导入语句。
易错点:重复安装、在多个文件里重复写安装命令、导入后未使用、把包名写成相对路径 ./@reduxjs/toolkit,都是常见问题。先守住这两步,再进入后续 createSlice 和 configureStore 的具体使用。
本节要解决的问题
Redux Toolkit 把“状态放哪儿、怎么读、怎么改、怎么监听”串成一条线:用 createSlice 定义切片,用 configureStore 组装仓库,用 store.getState() 读数据,用 store.dispatch(actionCreator(payload)) 改数据,用 store.subscribe() 监听变化。为什么需要这样?因为多个切片的数据要集中管理,修改必须走统一入口,否则任意赋值会让状态变化不可追踪。怎么想?先定义切片初始状态和 reducer,再把切片 reducer 交给仓库,最后在仓库外部只通过 API 操作。易错点:不要在组件或普通代码里直接改 store 内部数据,修改应交给 reducer。
说明:转写稿主要内容是路由参数、懒加载、Bootstrap 路径和 hash 模式,与本节“创建仓库”不是同一主题,不能把 query/state 参数推导硬搬进来;只采用其中“先打印看结构,再决定怎么取值”的调试思路。转写稿里“战位服”应纠正为“占位符”,但那是路由内容,本节不展开。
创建仓库:configureStore
为什么需要:切片只是“状态模块”,还要有仓库把多个切片组合起来。怎么想:createSlice 负责定义 name、initialState、reducers;configureStore 的 reducer 对象负责把 count、user 两个分支挂到仓库上。怎么做:先创建切片,再从 slice.actions 取 actionCreator,最后配置 store。易错点:configureStore({ reducer: { count: countSlice.reducer } }) 里传的是 slice.reducer,不是整个 slice;仓库 state 的结构由 reducer 对象的 key 决定。
js
// 1. 导入 createSlice包
import {createSlice, configureStore} from '@reduxjs/toolkit'

// 2. 创建切片
const countSlice = createSlice({
    name:'count',// name:指定切片名
    initialState:{// 切片数据
        num:99,
        msg:'atguigu'
    },
    reducers:{
        /**
         *
         * @param {*} state  切片状态数据
         * @param {*} action {type:'count/addNum',payload:数据}
         * 没创建一个reducer方法,redux会自动帮我们创建一个同名的方法,在切片的 actions属性上,该方法的身份是,actionCreator
         */
        addNum(state, action){
            state.num += action.payload
        },
        changeMsg(state, action){
            state.msg += action.payload
        }
    }
})
// 获取actionCreator
let {addNum, changeMsg} = countSlice.actions;

const userSlice = createSlice({
    name:'user',
    initialState:{
        username:'atguigu',
        age:10
    },
    reducers:{
        addAge(state, {payload}){
            state.age += payload
        }
    }
})
// actionCreator  addAge
const {addAge} = userSlice.actions;

// 创建仓库
const store = configureStore({
    reducer:{
        count: countSlice.reducer,
        user: userSlice.reducer
    }
})
console.log('store: ',store);

// 获取仓库数据  store.getState()
console.log('store.getState(): ', store.getState());

// 如何修改切片数据    只有reducer中的方法【程序员才能修改数据】
// 项目经理分配一个任务给产品经理,产品经理创建一个需求,将需求给程序员开发

store.dispatch(addNum(3));// addNum(3) ==> {type:'count/addNum',payload:3}
// 触发 count切片中的addNum函数的执行,并且将 action对象作为第二个参数传过去

console.log(store.getState());

// 监听store中数据的变化,当仓库数据发生修改时,会触发回调函数的执行。返回值是取消监听的函数,如果调用执行,那么就会取消监听
const unsubscribe = store.subscribe(()=>{
    console.log('subscribe: ',store.getState());
})

store.dispatch(addNum(5))
unsubscribe();// 取消监听
store.dispatch(addNum(7))获取仓库数据:store.getState()
为什么需要:派发前后都要确认状态是否按预期变化。怎么想:先 console.log(store) 看仓库结构,再 console.log(store.getState()) 看当前快照;本例应看到 count.num、count.msg、user.username、user.age。怎么做:直接调用 store.getState(),不要把它当成会自动更新的变量。易错点:getState() 返回的是当前时刻快照;要拿最新值,应在 dispatch 后或 subscribe 回调里重新调用。
修改切片状态:store.dispatch(actionCreator(payload))
为什么需要:统一入口才能触发 reducer、更新 state、通知订阅者。怎么想:addNum(3) 不是直接改 num,而是生成类似 {type:'count/addNum',payload:3} 的 action;dispatch 把它交给仓库,匹配到 count 切片的 addNum。怎么做:从 slice.actions 解构 actionCreator,调用后传给 dispatch。易错点:不要写 store.getState().count.num = 100;actionCreator 要从 slice.actions 取;payload 要和 reducer 中的使用一致。RTK 允许在 reducer 里写 state.num += action.payload,是因为内部使用 Immer,但这仍然只应发生在 reducer 中。
监听和取消监听仓库数据变化
为什么需要:状态变化后可能要同步日志、本地存储或更新外部系统。怎么想:subscribe 注册回调,返回 unsubscribe;调用 unsubscribe() 后不再监听。怎么做:先订阅,再派发;取消后再派发,观察回调是否还执行。易错点:unsubscribe 是函数,要加括号调用;订阅回调里应重新 getState() 取最新值;取消监听不会撤销已经发生的状态修改。
js
// 监听
const unsubscribe = store.subscribe(()=>{

})
// 取消监听
unsubscribe();调试顺序与易错点
建议按“打印 store → 打印 getState() → dispatch → 再打印 getState() → 订阅 → 派发 → 取消订阅 → 再派发”的顺序验证。易错点集中在:切片 reducer 挂载 key 写错、actionCreator 没从 slice.actions 取、把 getState() 当响应式数据、忘记调用 unsubscribe()。本节代码里的 console.log 就是最直接的调试证据。
先说明内容对应关系
本节笔记标题写的是“store 模块化使用”,但笔记正文为空,转写稿实际讲解的是路由参数传递、路由懒加载、bootstrap 路径和 hash/history 模式。为避免编造未出现的内容,下面按转写稿实际内容整理;本节没有出现图片,代码按转写稿中的片段保留并纠正同音字。
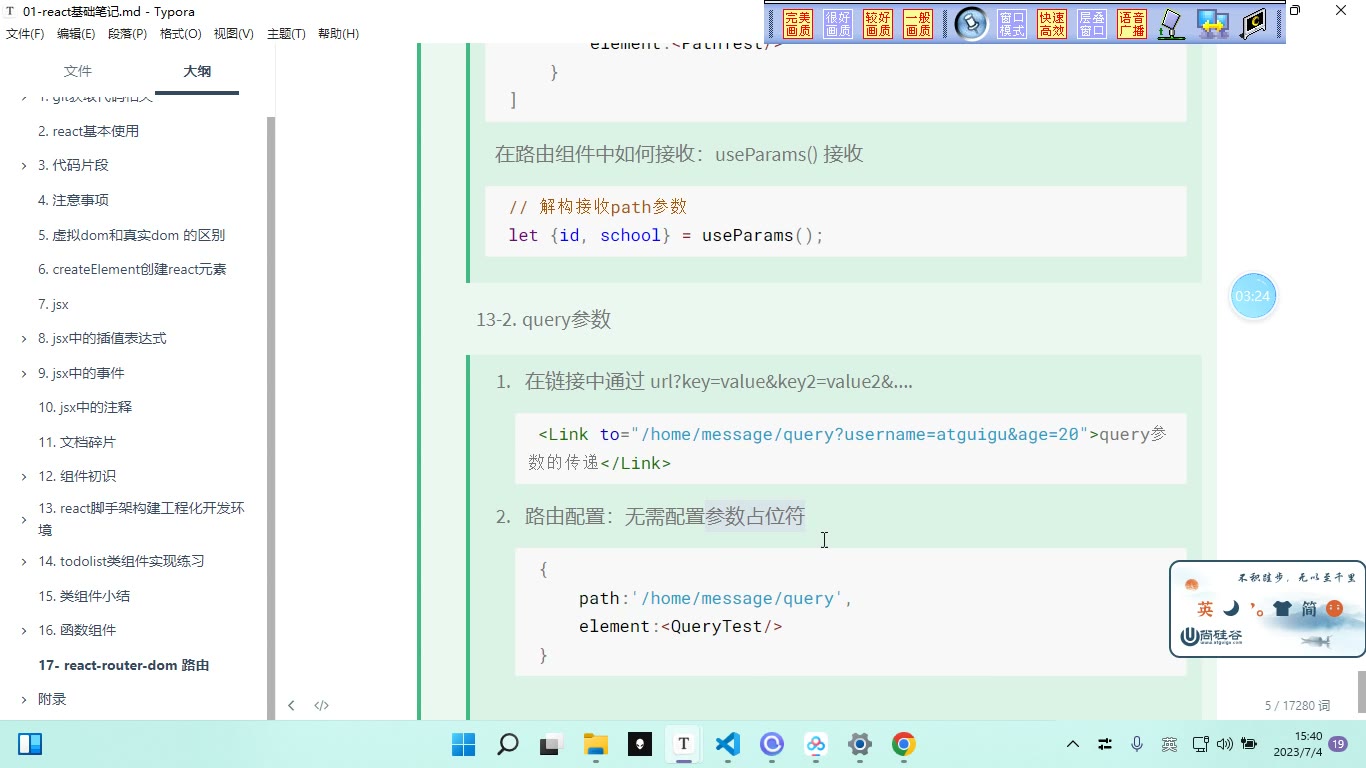
query 参数:传参简单,取值要经 get
为什么需要:有些数据只是查询条件,比如用户名、年龄,放在 URL 查询字符串里最直观。怎么想:query 参数不需要在路由配置里写占位符,因为 ?key=value&key2=value2 已经把键值明确写出来了。怎么做:把普通 a 标签换成 Link,href 改成 to,路径后拼查询字符串:
jsx
<Link to="/home/message/query?username=@硅谷&age=20">query 参数</Link>路由配置仍是普通路径,不需要额外占位符:
jsx
{
  path: "query",
  element: <QueryTest />
}组件里用 useSearchParams 接收。注意它返回的是数组,第一项是对象,要通过原型上的 get 方法取值:
jsx
let [searchQuery, setSearchQuery] = useSearchParams();
let username = searchQuery.get("username");
let age = searchQuery.get("age");设置参数时调用解构出来的函数,例如:
jsx
setSearchQuery("username=尚硅谷&age=100");易错点:不要以为 useSearchParams 第一项能直接点出 username;转写稿中打印后能看到它是对象,但值要用 get("username") 取。query 的好处是传参简单、路由无需特殊配置,缺点是取值比 params 麻烦。
state 参数:可传复杂类型,但不体现在地址栏
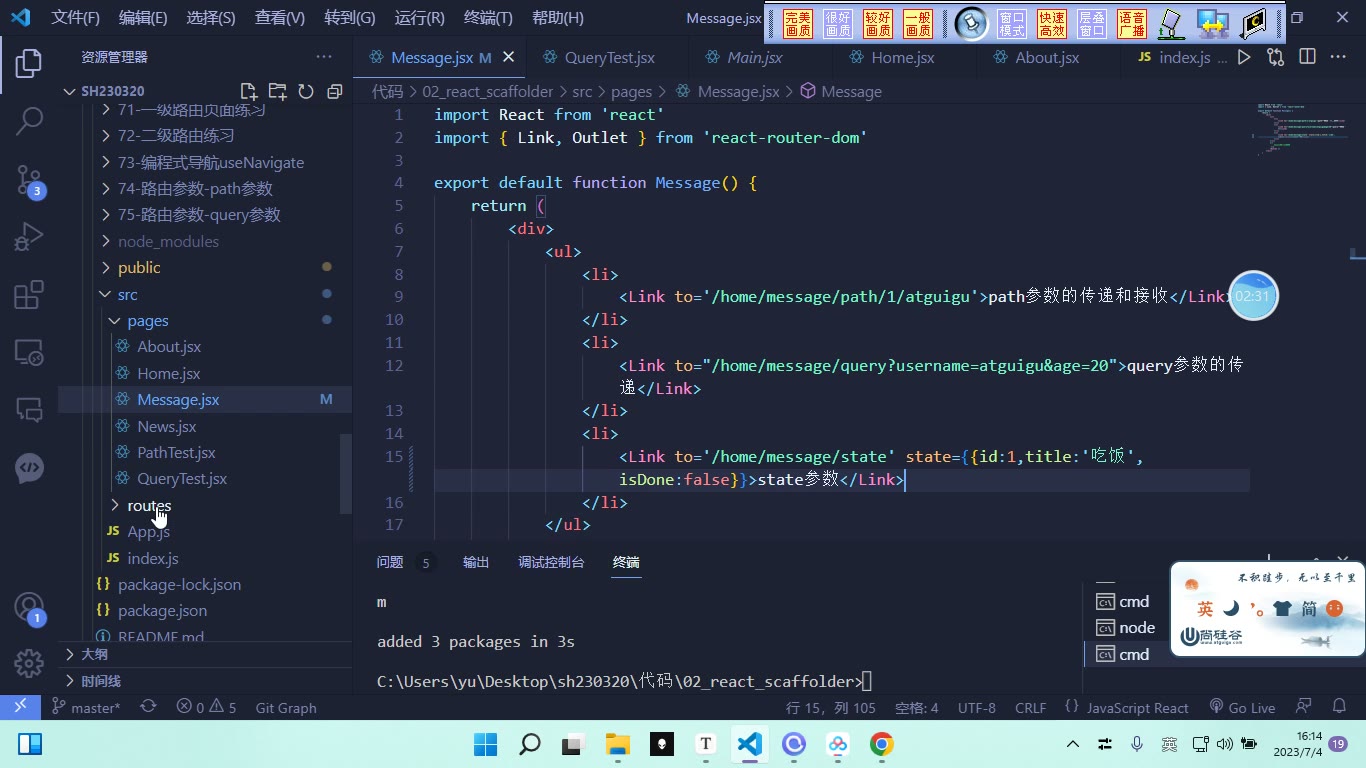
为什么需要:有时要传对象、数组等复杂数据,query 只能拼基本类型,state 更合适。怎么想:state 参数通过 Link 的 state 属性传,不写在 URL 里。怎么做:
jsx
<Link to="/home/message/state" state={{ id: "1", title: "吃饭", isDone: false }}>
  state 参数
</Link>路由配置同样不需要特殊配置。组件里用 useLocation 接收:
jsx
const x = useLocation();
const { id, title, isDone } = x.state;转写稿强调,解构时要看清结构:数据在 location.state 里,所以也可以写成与结构一致的形式。渲染布尔值时用三元表达式,例如 isDone ? "已完成" : "未完成"。
易错点:state 参数刷新后地址栏没有任何体现,用户不知道数据从哪来;转写稿也明确说这种方式用得相对少,query 和 params 更常用。
路由懒加载:lazy 与 Suspense 配合
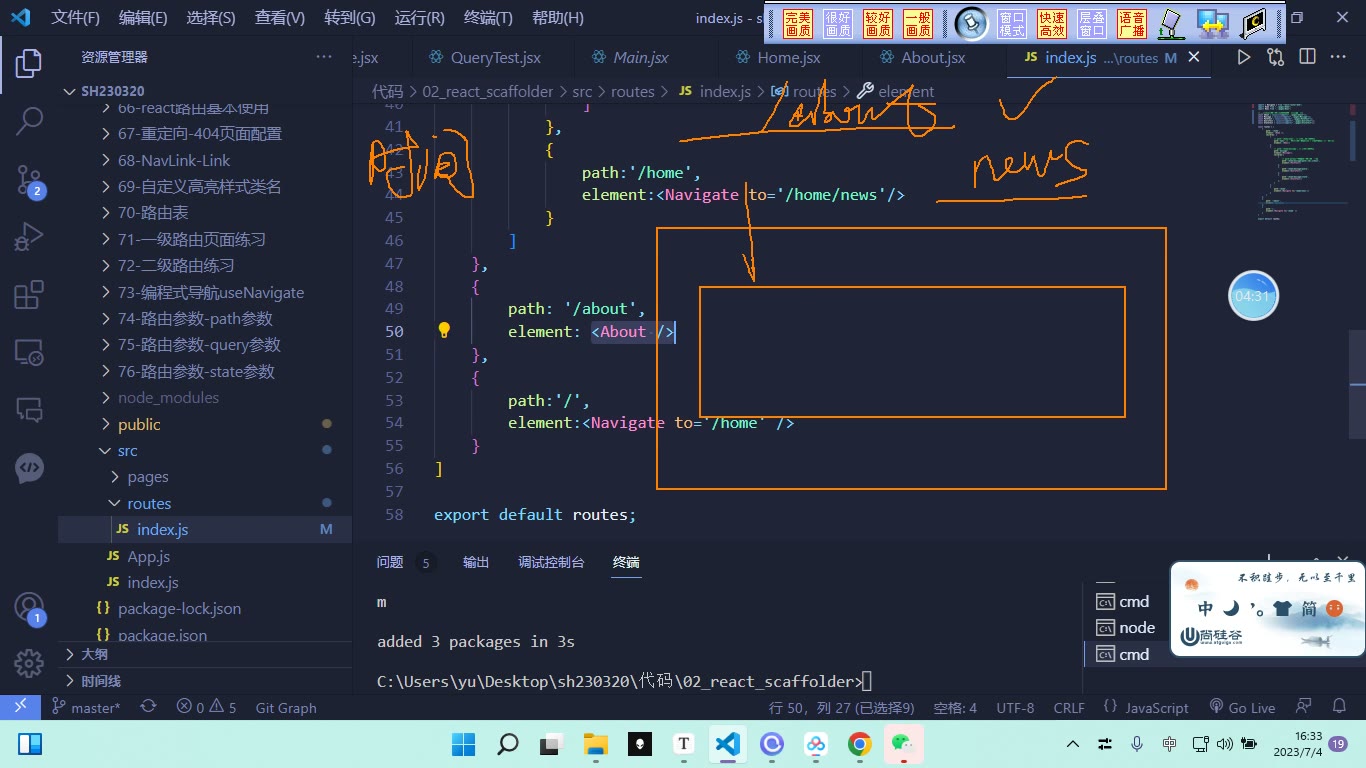
为什么需要:如果 routes/index.js 一开始就 import 所有路由组件,用户只看首页,也会把全部页面加载一遍。怎么想:首页必须加载,其他页面点开再加载,即按需加载/懒加载。怎么做:从 react 引入 lazy 和 Suspense,用 lazy(() => import("路径")) 加载组件:
jsx
const About = lazy(() => import("./About"));懒加载组件必须用 Suspense 包裹,fallback 是加载未完成时显示的内容:
jsx
<Suspense fallback={<div>组件正在加载中</div>}>
  <About />
</Suspense>转写稿中把所有懒加载路由都套上 Suspense,并进一步封装 load 函数,减少重复代码。易错点:转写稿调试时出现报错,原因就是某个懒加载组件忘了包 Suspense;只要用了 lazy,就要检查是否都有 Suspense。
bootstrap 样式丢失:不要写相对路径
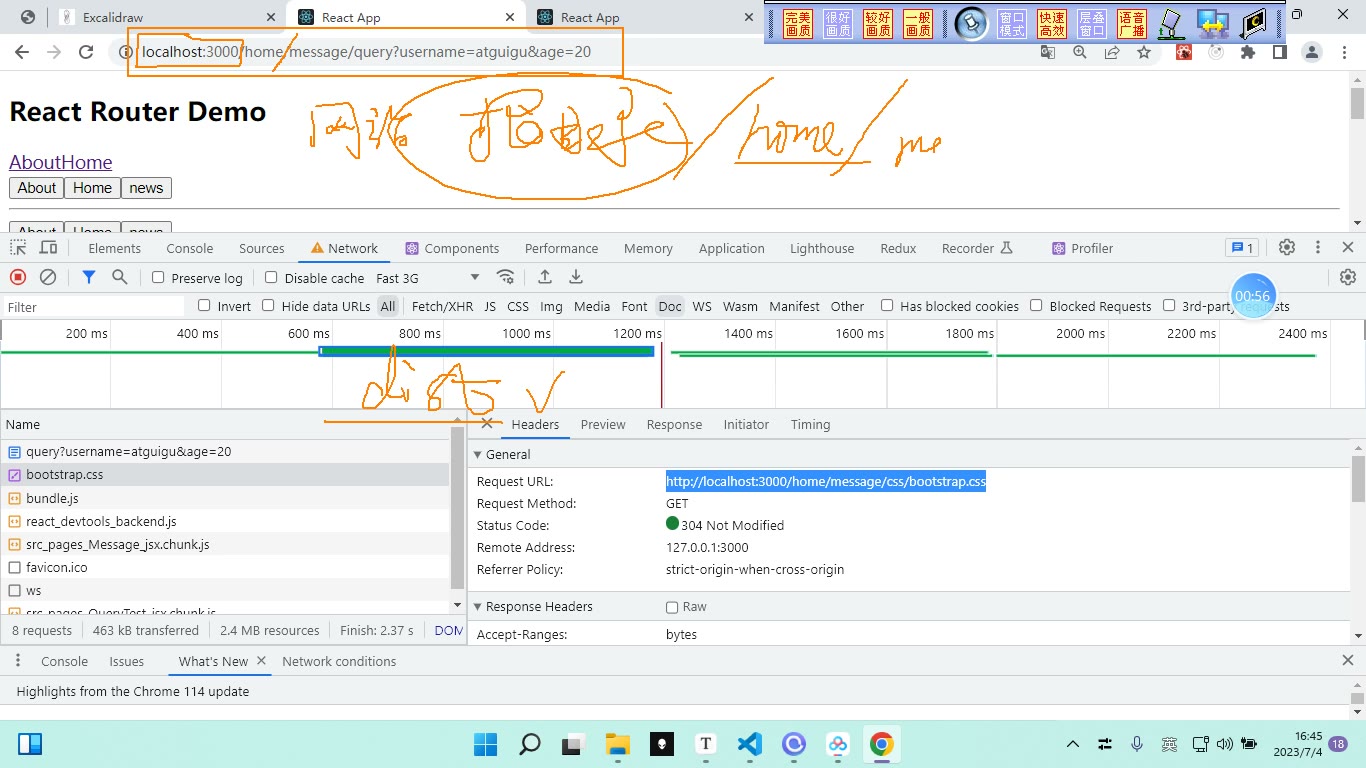
为什么需要:刷新页面后样式飞了,检查发现 bootstrap 没加载成功。怎么想:./css/bootstrap.css 是相对路径,多级路由下会把前面的路由也当目录,去错误位置找文件。怎么做:改成 /css/bootstrap.css,斜杠表示网站根目录,也就是 public/打包后的目录。易错点:路由层级越深,相对路径越容易出错;转写稿明确要求“千万不要加点”。
hash 与 history 模式的区别
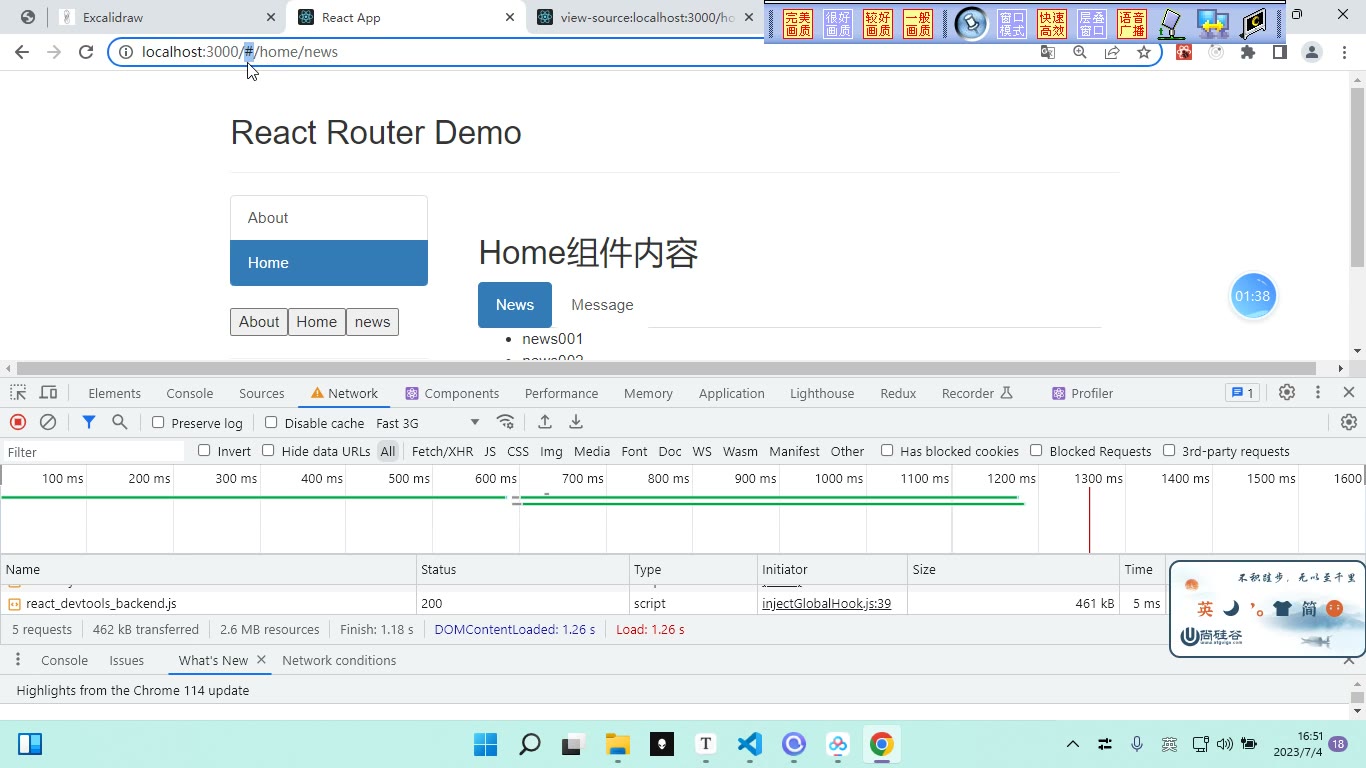
为什么需要:BrowserRouter 对应 HTML5 history 模式,路径是 /home/news;HashRouter 对应 hash 模式,路径带 #。怎么做:把包裹 APP 的 BrowserRouter 换成 HashRouter 即可。易错点:hash 模式路径不干净,但相对路径下刷新样式不易丢;实际网站多用 history 模式,因此仍要养成写绝对路径的习惯。
课堂画面
代码示例
示例 1:redux-toolkit 基本使用(创建切片 → 创建仓库 → 获取数据 → 修改状态)
js
// package.json 中需添加 "type": "module",否则 node 直接运行会报 import 语法错误
// 安装:npm install @reduxjs/toolkit

// 1. 导入 createSlice、configureStore
import { createSlice, configureStore } from '@reduxjs/toolkit'

// 2. 创建切片
const countSlice = createSlice({
  name: 'count', // 切片名,会作为 action type 的前缀
  initialState: {
    // 切片数据
    num: 99,
    msg: 'atguigu'
  },
  reducers: {
    /**
     * @param {*} state  切片状态数据
     * @param {*} action {type:'count/addNum', payload:数据}
     * 每创建一个 reducer 方法,redux 会自动帮我们创建一个同名方法挂在切片的 actions 属性上,
     * 该方法的身份是 actionCreator
     */
    addNum(state, action) {
      state.num += action.payload
    },
    changeMsg(state, action) {
      state.msg += action.payload
    }
  }
})

// 获取 actionCreator
const { addNum, changeMsg } = countSlice.actions

// 3. 创建仓库
const store = configureStore({
  reducer: {
    count: countSlice.reducer
  }
})
console.log('store: ', store)

// 4. 获取仓库数据 store.getState()
console.log('store.getState(): ', store.getState())

// 5. 如何修改切片数据:只有 reducer 中的方法才能修改数据
console.log(addNum(3)) // { type: 'count/addNum', payload: 3 }

store.dispatch(addNum(3)) // 触发 count 切片中 addNum 的执行,并把 action 对象作为第二个参数传进去
console.log(store.getState())

store.dispatch(changeMsg('!'))
console.log(store.getState())要点解释与易错点
createSlice的三个参数缺一不可:name、initialState、reducers;name决定了自动生成的 action type 为切片名/方法名(如count/addNum)。reducers里写的每个方法,redux-toolkit 会自动生成同名的 actionCreator 放在slice.actions上,必须解构出来再 dispatch,不能直接store.dispatch(addNum)传函数本身。- 修改状态写
state.num += action.payload(直接“改”state),这是 Immer 的能力,不要写成state = {...state, num: ...},那样不会生效。 - 取参数统一用
action.payload(也可解构{ payload }),名字是固定的,写成action.data拿不到值。 configureStore的参数是对象{ reducer: { count: countSlice.reducer } },注意这里是countSlice.reducer(单数),不是reducers。- 易错点:直接
store.getState().count.num = 100改数据——绕过了 reducer,页面/监听都不会有正确响应,必须dispatch。
示例 2:多个切片合并进同一个仓库(store 模块化结构)
js
import { createSlice, configureStore } from '@reduxjs/toolkit'

// ---- count 切片 ----
const countSlice = createSlice({
  name: 'count',
  initialState: {
    num: 99,
    msg: 'atguigu'
  },
  reducers: {
    addNum(state, action) {
      state.num += action.payload
    },
    changeMsg(state, action) {
      state.msg += action.payload
    }
  }
})
const { addNum, changeMsg } = countSlice.actions

// ---- user 切片 ----
const userSlice = createSlice({
  name: 'user',
  initialState: {
    username: 'atguigu',
    age: 10
  },
  reducers: {
    addAge(state, { payload }) {
      state.age += payload
    }
  }
})
// actionCreator  addAge
const { addAge } = userSlice.actions

// 创建仓库:reducer 用对象,key 就是 state 里的分支名
const store = configureStore({
  reducer: {
    count: countSlice.reducer,
    user: userSlice.reducer
  }
})

console.log(store.getState())
// { count: { num: 99, msg: 'atguigu' }, user: { username: 'atguigu', age: 10 } }

store.dispatch(addNum(3))
store.dispatch(addAge(5))

// 读取时按分支名取值
console.log(store.getState().count.num) // 102
console.log(store.getState().user.age) // 15要点解释与易错点
configureStore({ reducer: { count: ..., user: ... } })中的 key 就是最终 state 的分支名,getState()得到的是{ count: {...}, user: {...} }这种嵌套结构,取值必须带分支名(getState().user.age)。- 每个切片只管理自己那份
initialState,切片之间互不干扰;把切片拆到不同文件、再在store/index.js里统一configureStore,就是 store 模块化的做法。 - 易错点:多个切片用了相同的
name,会导致 action type 冲突(如两个count/addNum),一定要保证切片名唯一。 - 易错点:
addAge(5)中addAge是从userSlice.actions解构出来的,如果误从countSlice.actions解构会得到undefined,dispatch 时报错。
示例 3:监听与取消监听仓库数据变化(store.subscribe)
js
import { createSlice, configureStore } from '@reduxjs/toolkit'

const countSlice = createSlice({
  name: 'count',
  initialState: { num: 99, msg: 'atguigu' },
  reducers: {
    addNum(state, action) {
      state.num += action.payload
    }
  }
})
const { addNum } = countSlice.actions

const store = configureStore({
  reducer: { count: countSlice.reducer }
})

// 监听 store 中数据的变化,数据被修改时触发回调;返回值是取消监听的函数
const unsubscribe = store.subscribe(() => {
  console.log('subscribe: ', store.getState())
})

store.dispatch(addNum(5)) // 触发回调,打印 { count: { num: 104, msg: 'atguigu' } }

unsubscribe() // 取消监听

store.dispatch(addNum(7)) // 不再触发回调,但数据依然被修改
console.log(store.getState()) // { count: { num: 111, msg: 'atguigu' } }要点解释与易错点
store.subscribe(fn)的返回值unsubscribe是取消监听函数,必须接收并保存,否则无法取消监听(比如组件卸载时不取消就会造成泄漏)。- 回调里拿最新数据要用
store.getState()重新获取,不要依赖外部闭包里的旧变量。 - 易错点:以为
unsubscribe()会阻止数据修改——它只是停止回调,dispatch依然会改数据。 - 易错点:每次
dispatch都会触发一次回调,一次操作里连续 dispatch 多次就会打印多次,需要合并时应在业务层合并 action。
常见错误
现象:调用
addNum(3)后store.getState()里的num没有变化,或报 “Actions must be plain objects”。 原因:把 actionCreator 当成普通函数直接调用,没有交给dispatch;或者试图在组件里直接改 state。 修法:写成store.dispatch(addNum(3)),actionCreator 只负责产出{type, payload},修改状态一律走 dispatch。现象:在 reducer 里写
state = { ...state, num: state.num + 1 }后数据不更新,或后续 mutate 报错。 原因:RTK 内部用 Immer 的 draft,重新给state变量赋值会丢掉 draft 引用;同时“既重新赋值又直接改”是混用两种写法。 修法:reducers 内二选一——要么直接state.num += action.payload,要么return { ...state, num: ... },不要给state重新赋值。现象:
store.getState()拿到{ count: {...}, user: {...} },组件里却按state.num取值,得到undefined。 原因:configureStore({ reducer: { count, user } })中每个 key 就是一层命名空间,state 结构由这些 key 决定。 修法:按命名空间取store.getState().count.num;组件里用useSelector(state => state.count.num)。现象:调用了
unsubscribe()之后回调还在打印;或页面切换多次后控制台日志成倍增加。 原因:subscribe返回的取消函数没有保存/没有在组件卸载时调用;或者每个组件各订阅一次却没人清理。 修法:const unsub = store.subscribe(fn)保存返回值,在确定不再需要时(如useEffect的 cleanup)调用unsub()。现象:store 模块化拆分后启动报
Cannot access 'xxx' before initialization,或某个 slice 的 actions 是undefined。 原因:slice 文件里import store,store 文件里又import slice,形成循环依赖。 修法:slice 文件只导出actions和reducer,不引用 store;store 只在store/index.js里汇总组装,组件通过 hooks 拿数据。现象:路由懒加载的组件一切换就白屏,控制台报 Suspense 相关错误。 原因:
lazy()加载的组件没有用<Suspense fallback={...}>包裹,加载期间没有兜底 UI。 修法:所有lazy组件统一用 Suspense 包裹(可封装成load(Component)高阶函数),fallback 给 loading 提示。现象:多级路由下刷新页面,bootstrap 样式丢失,Network 里 CSS 请求 404。 原因:样式用相对路径
./css/bootstrap.css,浏览器把当前多级路由当成目录去拼接。 修法:改成以/开头的绝对路径/css/bootstrap.css,永远从站点根目录(public)找。
练习
新建
todoSlice,initialState为{ list: [] },实现addTodo(payload 为文本)、removeTodo(payload 为 id)、toggleTodo(payload 为 id)三个 reducer,并把 slice 注册进configureStore,用dispatch连续添加两条再删除一条,打印每一步的getState()。写一段验证代码:先
subscribe打印状态,然后 dispatch 三次,调用unsubscribe(),再 dispatch 一次。说明控制台一共打印几次、为什么。把课堂示例中的
count和user拆成store/countSlice.js、store/userSlice.js、store/index.js三个文件,要求 slice 文件里不出现import store,并验证getState()的结构与拆分前完全一致。在
countSlice的addNum里分别用“直接 mutate”和“return新对象”两种写法实现同一逻辑,各 dispatch 一次,对比结果;再故意写一次state = { ...state, num: 100 },观察并解释现象。用
lazy+Suspense封装一个load(Component)函数,把 About、Message 两个路由组件改成懒加载,并解释 fallback 里应该放什么内容、为什么不能省略。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 路由参数传递-query参数 | 10:13 |
| 2 | 路由参数传递-state参数 | 07:34 |
| 3 | 路由懒加载 | 15:26 |
| 4 | bootstrap引入使用相对目录导致文件加载失败的原因 | 04:59 |
| 5 | html5-history模式-hash路由模式区别 | 04:54 |
小结
slice.actions上的方法与 reducers 里的方法同名,这是 RTK 自动生成的 actionCreator,不要手写{type:'count/addNum'}。- 仓库的 state 形状由
configureStore中 reducer 对象的 key 决定,拆几个 slice 就有几层命名空间。 - Immer 让“直接改 state”在 reducers 内成为合法写法,但这条特权只存在于 reducers 内部,出了 reducers 一律 dispatch。
subscribe是全局的、粗粒度的,适合调试和少量副作用;组件取数应优先用useSelector。- 模块化的正确方向是:slice 只依赖自身,store 汇总 slice,组件依赖 store 的 hooks,禁止反向 import。
- 懒加载是“用的时候才加载”,必须配 Suspense 兜底,否则加载时间差会表现为白屏。
- 静态资源路径一律用
/开头,不要用./,这样无论路由多深、用 history 还是 hash 模式都不会丢样式。 - history 模式路径干净、是实际项目的主流选择;hash 模式路径带
#,但天然规避多级路由下的相对路径问题。